制造业 AI · FDE · 知识 Agent
AI找到了答案,却差点用错手册:一次苏州制造业FDE项目复盘
制造业知识库最危险的情况,不是查不到资料,而是查到一份看起来正确、实际上已经失效的资料。
先说明一下:为保护企业信息,下面的地点和组织信息按苏州场景做了脱敏改写,不对应具体公司;项目过程与数据沿用原始案例素材。
前段时间,我在苏州大市范围内做了一个 FDE 项目。
客户总部在苏州工业园区,工厂在昆山,物流和售后在吴江。公司做的产品很窄,技术积累很深。很多关键经验没有写进系统,仍留在几位老师傅脑子里。
老板最初的需求很大:做一个全公司都能用的智能 Agent。
我们没有从这个宏大目标开始,而是跟着售后跑了一张真实工单。
查序列号,确认设计版本,翻 BOM,核对供应商批次,再找出厂检测、维修记录和传感器曲线。资料凑齐后,还要给园区总部的老师傅打电话,让他凭经验作最后判断。
光是准备判断材料,就花了将近两个小时。
这看起来像一个很适合知识库的场景。资料分散,查询费时,专家经验稀缺,把文档接进大模型,似乎就能解决大半问题。
第一版 RAG 也很快跑通了。提问之后,系统会从维修手册里找答案,附上引用,演示效果相当顺。
直到质量部长问了一句:
"引用的是哪个版本的维修手册?"
系统找出的是 2021 版。眼前这台设备用的却是 2023 年改版后的密封结构。
答案和旧手册完全一致,可要是现场照着操作,存在造成二次污染的风险。
会议室一下安静了。
制造业AI最怕的,是"有依据地答错"
互联网内容里,一个答案大体正确,也许已经够用。
制造现场不是这样。维修、换件、停机和质量责任都可能牵连真实设备。十次操作里只错一次,也不能被轻描淡写地归进"模型偶尔会幻觉"。
更麻烦的是,这次系统并没有胡编。
它找到了真实文件,引用了真实段落,回答也符合文件内容。错误发生在另一层:文件已经过期,却仍被系统当成有效知识。
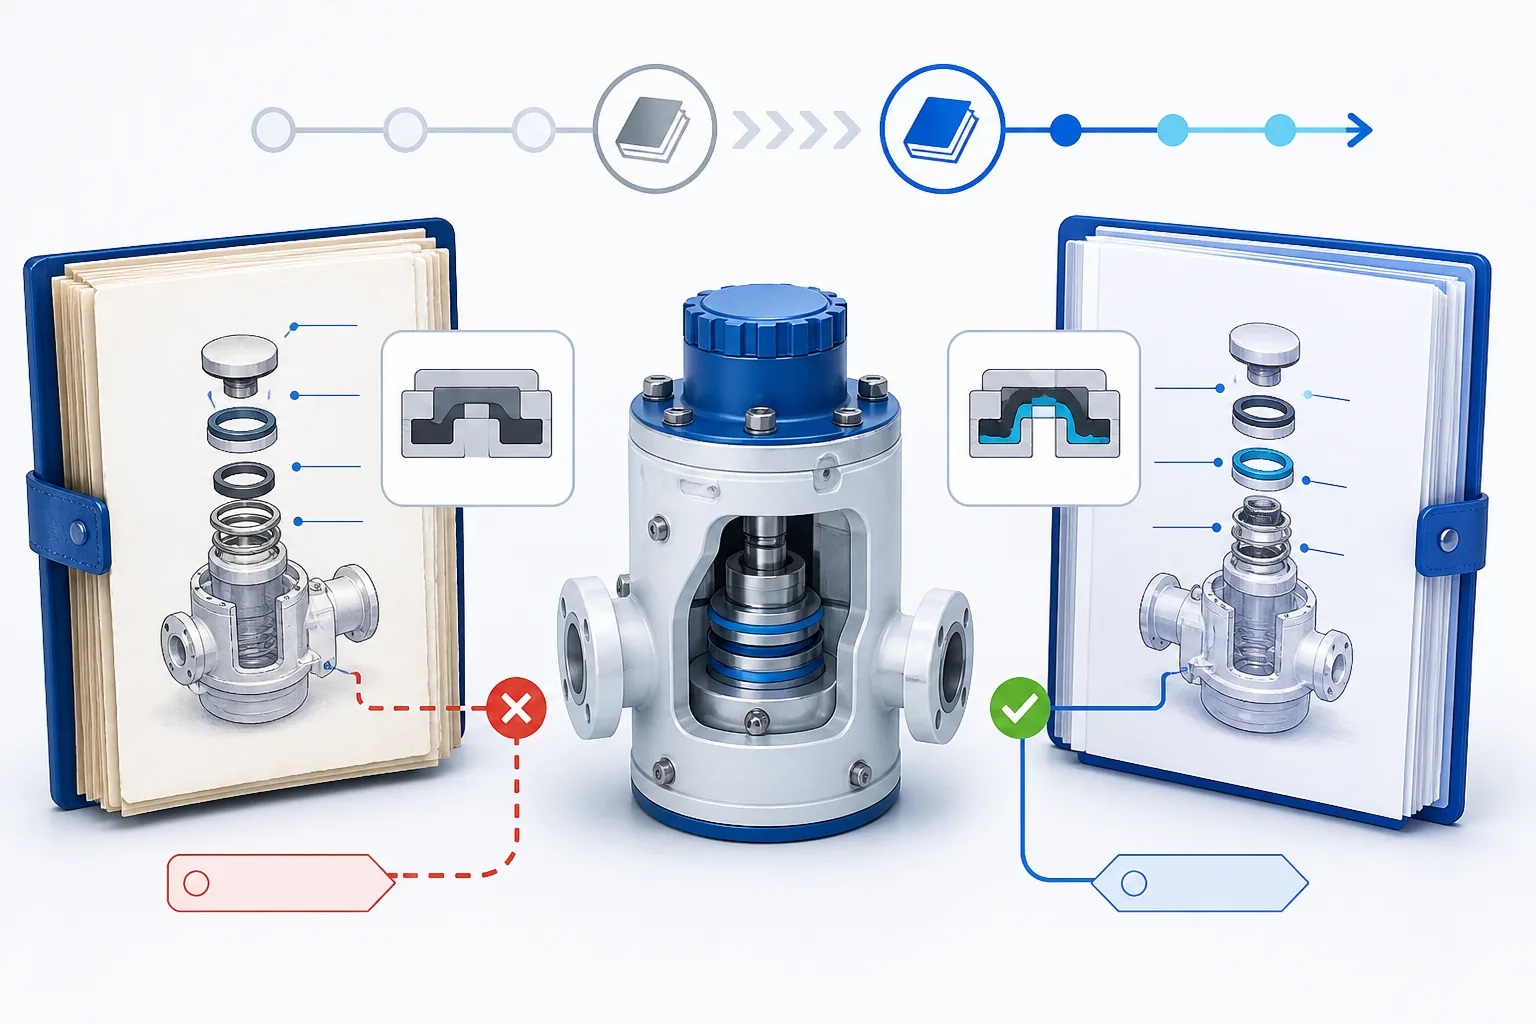
这暴露了许多企业知识库共有的漏洞。
我们把文档放进向量库时,习惯关注标题、正文和关键词,却很少同时保存这些信息:
• 这份文件从什么时候开始生效;
• 它适用于哪些产品、型号和设计版本;
• 哪份新文件已经替代了它;
• 哪些序列号仍可使用旧规则;
• 出现冲突时,以谁的结论为准。
语义相似只能说明"这段话看起来相关"。它无法自动证明"这段话适用于眼前这台设备"。
制造业 AI 要继续回答一个更具体的问题:"在此时、此地、这台设备上,这段知识还算不算数?"
我们没有换模型,先补了一条数据链
发现问题后,最容易做的动作是换一个更大的模型,或者继续调提示词。
我们没有这么做。
模型读错版本,根源不在语言理解。系统缺少设备身份,也不知道版本之间的继承和替代关系。给它更聪明的大脑,并不会凭空补出这些企业事实。
后面的主要工作,是把一条原本散落在不同部门的数据链重新接起来:
客户 → 设备 → 序列号 → 设计版本 → BOM → 供应商批次 → 出厂检测 → 维修记录 → 故障事件。
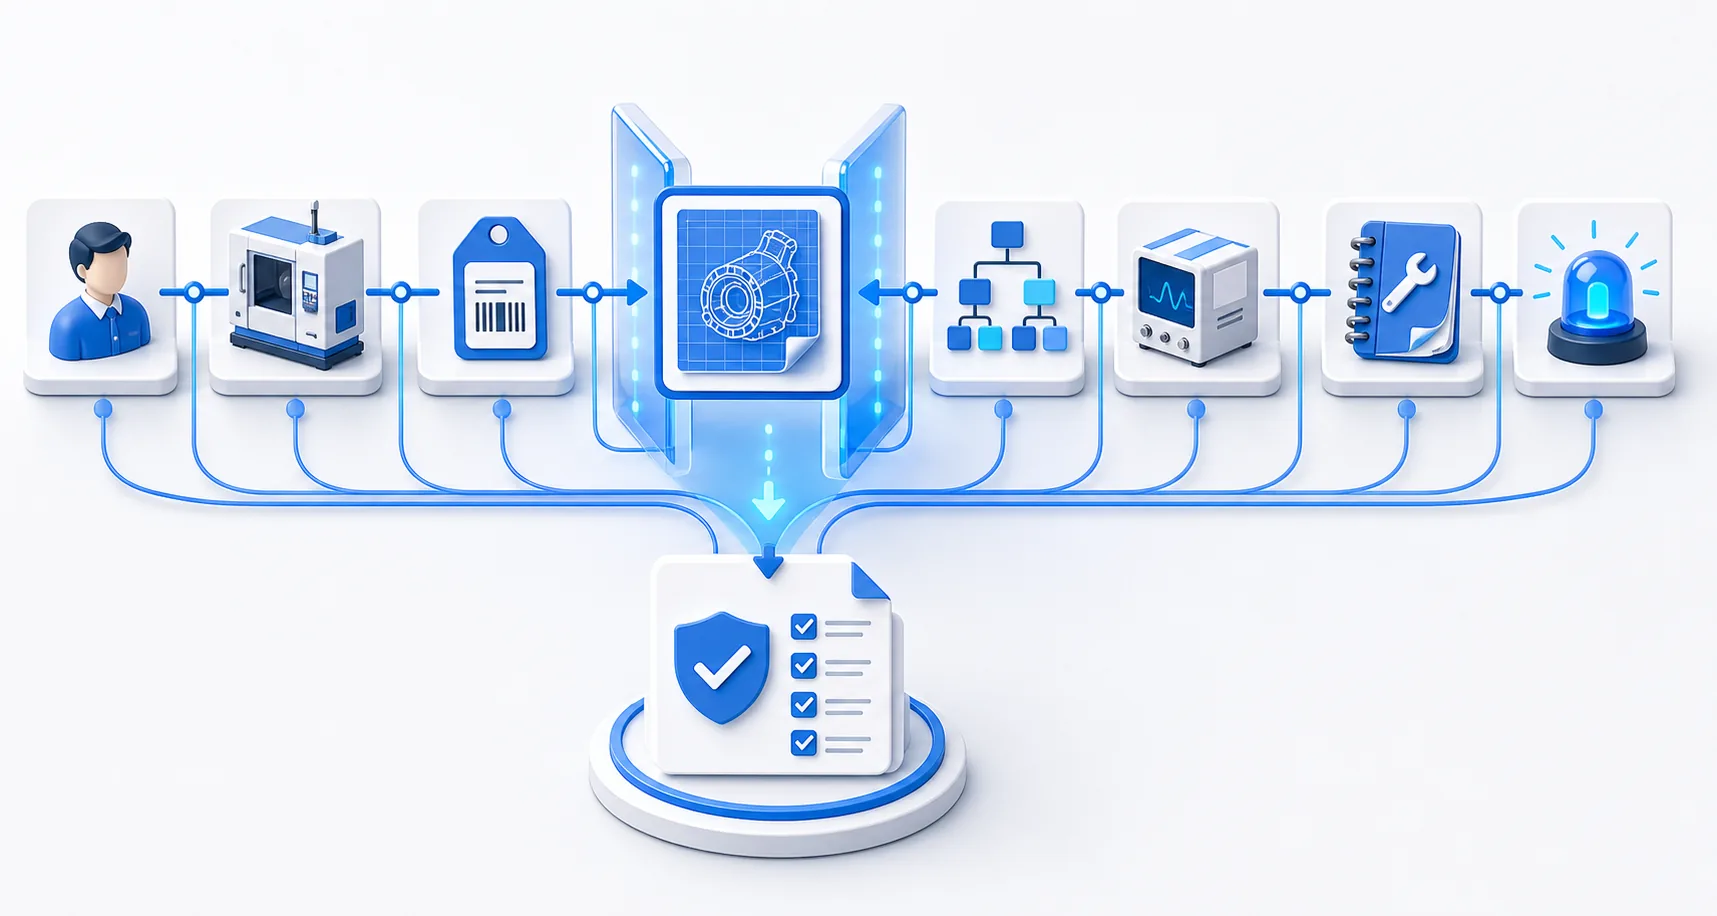
这条链有什么用?
售后输入序列号后,系统先确认设备身份和设计版本,再过滤适用手册;根据 BOM 和供应商批次缩小可能原因;结合出厂检测与维修记录,寻找相似故障;最后才让 Agent 组织答案。
输出也不再只有一段"建议"。它必须同时列出:
• 当前判断用了哪些资料;
• 每份资料对应什么版本和时间;
• 哪些证据支持这个判断;
• 有没有相反证据或冲突记录;
• 哪些信息仍然缺失。
涉及停机、换件和质量责任的结论,一律由工程师批准。Agent 可以准备材料、提出判断,不能替企业签字。
十二周后,快了很多,但没有出现效率神话
项目跑了十二周后,资料准备时间从九十多分钟降到二十多分钟。
首次有效回复原本经常超过一天,后来缩短到八小时左右。
这个结果对售后和质量部门已经有意义。但继续看整张工单,关闭周期只下降了不到三成。
原因并不神秘。
AI 加快了诊断材料的准备,却无法凭空调来备件,也不能替客户安排停机窗口,更不能绕过企业内部审批。
一张工单从报修到关闭,经过的不只是一段信息流程。中间还有物流、库存、人员排期、客户现场和责任确认。AI 只改快了其中一段,整条链路自然不会同比例提速。
这反而是一个值得保留的结果。
如果团队只展示"资料查询提速了多少倍",很容易让老板误以为整个售后周期都会同步下降。把局部指标和最终业务指标同时摆出来,才能知道 Agent 解决了什么,还有什么留在组织和物理世界里。
这类项目,FDE到底在做什么
外界谈 FDE,容易把他理解成驻场写 Agent 的工程师。
但在这个项目里,写代码只占了一部分时间。
更多时候,我们在园区、昆山和吴江之间来回跑:跟售后看工单,向老师傅确认例外,找 IT 对接口,和质量部门讨论哪些结论必须人工批准,再把一次现场争议写回数据规则与评测题。
FDE 要接的是四样东西:
1. 模型能理解的语言,与业务人员日常使用的语言; 2. 文档里的通用规则,与设备现场的版本事实; 3. Agent 给出的建议,与企业已有的权限和责任; 4. 一次项目交付,与下一次还能复用的系统能力。
如果每次遇到版本问题都靠现场工程师临时解释,项目只是多了一个更懂 AI 的老师傅。
只有把版本关系、证据链、人工闸门和错误反馈写进系统,下一张工单才会少依赖一个人的记忆。
制造企业做知识Agent,先检查这七个问题
准备做类似项目时,可以先拿一张真实工单回答下面的问题:
1. 系统能否唯一识别客户、设备和序列号? 2. 文档有没有生效时间、适用型号和版本范围? 3. 旧文件被替代后,系统是否知道它已经失效? 4. BOM、供应商批次、检测和维修记录能否串起来? 5. 回答是否同时展示证据、版本与相反信息? 6. 哪些动作必须由工程师确认,谁承担责任? 7. 项目验收看查询速度,还是看首次回复、关闭周期和返工?
只要前四个问题答不清,先别急着比较模型。
因为这时企业首先缺少一条事实链,用来证明"这份答案适用于这台设备"。
好的FDE,最后应该少被叫到现场
这个项目没有出现 Agent 接管公司,也没有一上线就让效率暴涨。
它只是把一段原本靠翻文件、打电话和凭记忆完成的工作,变成了有证据、能追溯、可以继续修正的流程。
但这已经很重要。
好的 FDE 能把系统交付出去。更老练的 FDE 还会继续问:老师傅退休后,这套判断能不能留下;下一次出现类似设备,是否还要从头排查;自己离场以后,客户能不能更新版本、补充案例、处理错误。
如果答案都是可以,FDE 才算把最后二十米接完。
项目做完之后,他被叫到现场的次数应该越来越少,而不是越来越多。
说明: 本文根据用户提供的项目素材重构。为保护企业信息,地点与组织信息已按苏州场景脱敏改写,案例中的效率数据沿用原始素材,不代表行业平均水平。
完