AI产品 · Agent · 企业落地
AI 越来越聪明,产品为什么还是不好用
系统做得越来越快,问题却未必找得越来越准。AI产品真正缺的,常常是验证、边界和反馈。
这两年做企业 AI 落地,我反复碰到一种很奇怪的产品。
它在会议室里几乎什么都会。
客户信息可以分析,购买意向可以判断,系统还能推荐方案、自动回复,顺手提醒销售下一步做什么。流程图铺满一整页,每个方框里都装着 AI。
等它进入真实业务,画风很快就变了。
客户正在投诉,系统发来一张优惠券。有人只是随口问问,AI 第二天又追过去提醒。准备购买的客户表达得比较克制,系统反而把他归进了低意向名单。
一线员工用过几次,开始绕开系统。管理层在报表里看不到成交变化。几个月以后,那套演示时让所有人点头的产品,安静地停在浏览器收藏夹里。
大模型确实越来越聪明。产品却没有因此自动变得好用。
做出一套系统,已经比确认一个问题更快
过去开发企业软件很贵。
公司要找产品、设计和研发,经历立项、排期与测试。投入大,大家在动手以前通常会追问谁来使用,准备解决什么问题,系统上线以后哪个数字会变化。
今天,一个人用现成模型、低代码平台和几组提示词,几天就能搭出一套外观完整的 AI 应用。它会聊天,也能查资料、写方案和调用工具。
产品外壳出现得太快,验证工作被甩在了后面。
一个还没见过真实客户的想法,很快就有了登录页、对话框和数据看板。几个测试样例跑通以后,它又有了一个听起来很大的产品名称。
这时最难问出口的那句话反而是,客户到底为什么需要它。
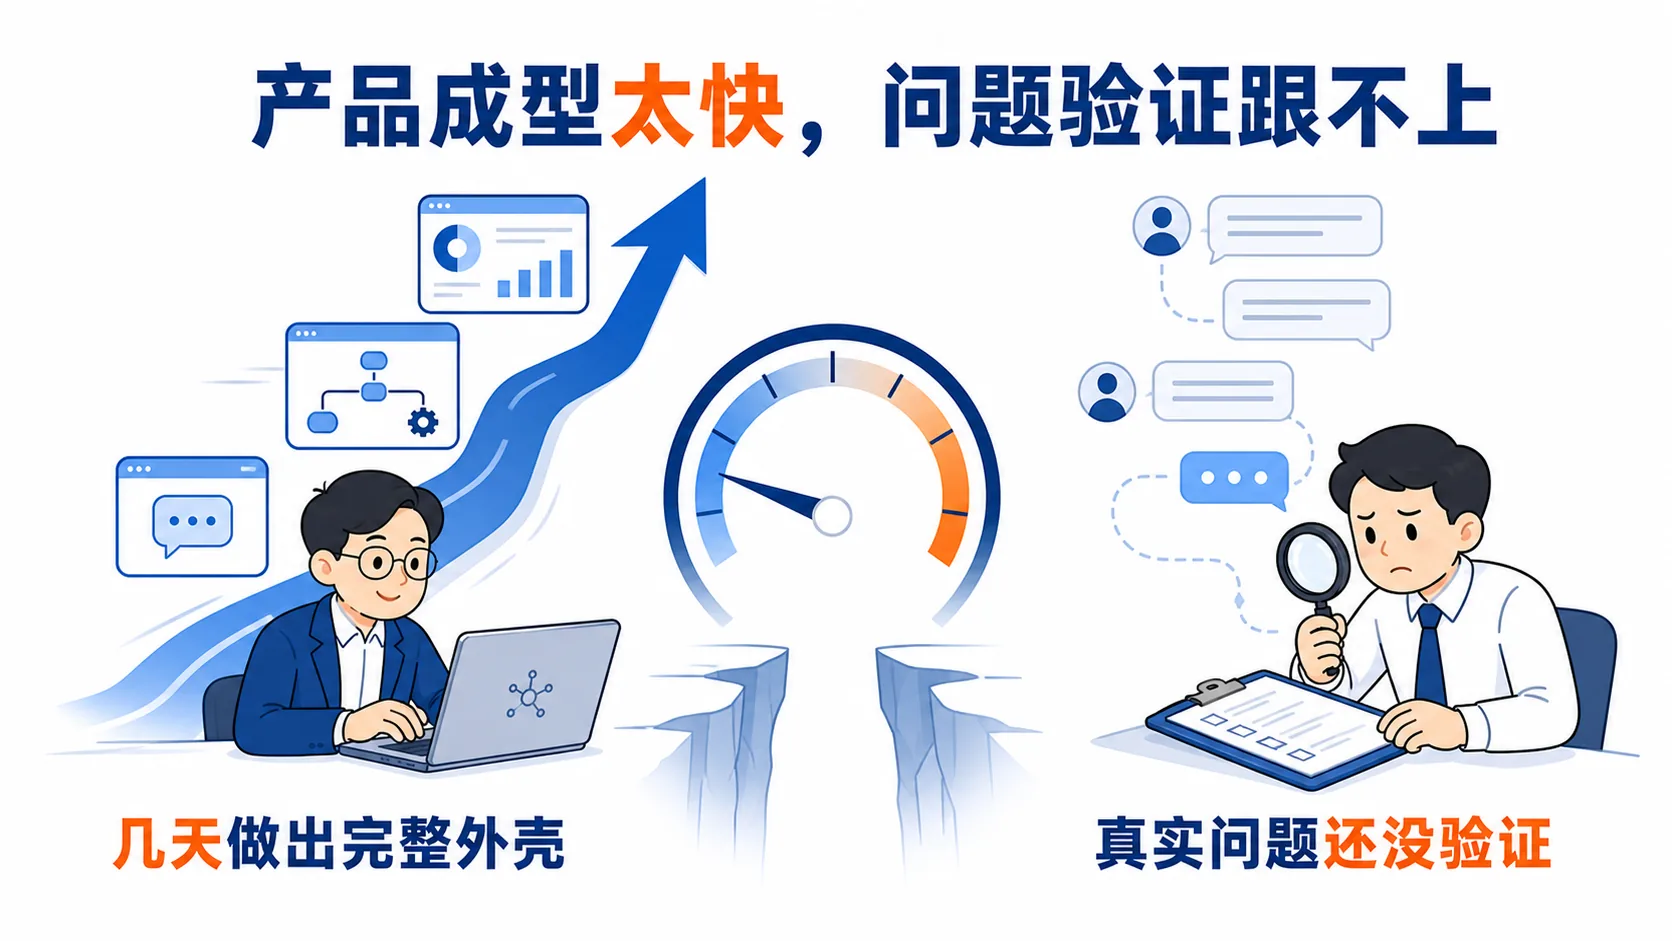
演示可以挑输入,也允许有人站在旁边解释。真实业务不会配合。客户会说半句话,会把抱怨夹在咨询里,也可能一边询价一边准备离开。
团队没有先收集这些真实情况,模型再强,也只能在一个想象出来的问题上表现优秀。
五个 AI 都很勤奋,客户仍然会被惹怒
很多销售系统会把工作拆成一条长链。
第一个 AI 判断客户目的,结果交给下一个 AI 评估购买意向。后面还有销售策略、回复生成和联系时间。每一段都有明确职责,听起来比一个模型包办全部工作可靠。
现在让一名要求退货的客户走进这条流程。
第一个 AI 把愤怒理解成价格抱怨,给出"仍有成交机会"的判断。第二步沿用这个前提,把客户标成正在比价。销售策略因此选择优惠,回复模型写出热情的促销信息,最后一个环节安排次日继续联系。
五个 AI 都按要求完成了任务。
系统也没有报错。接口正常返回,字段格式完全正确,日志一片绿色。只有客户收到消息以后更生气了。
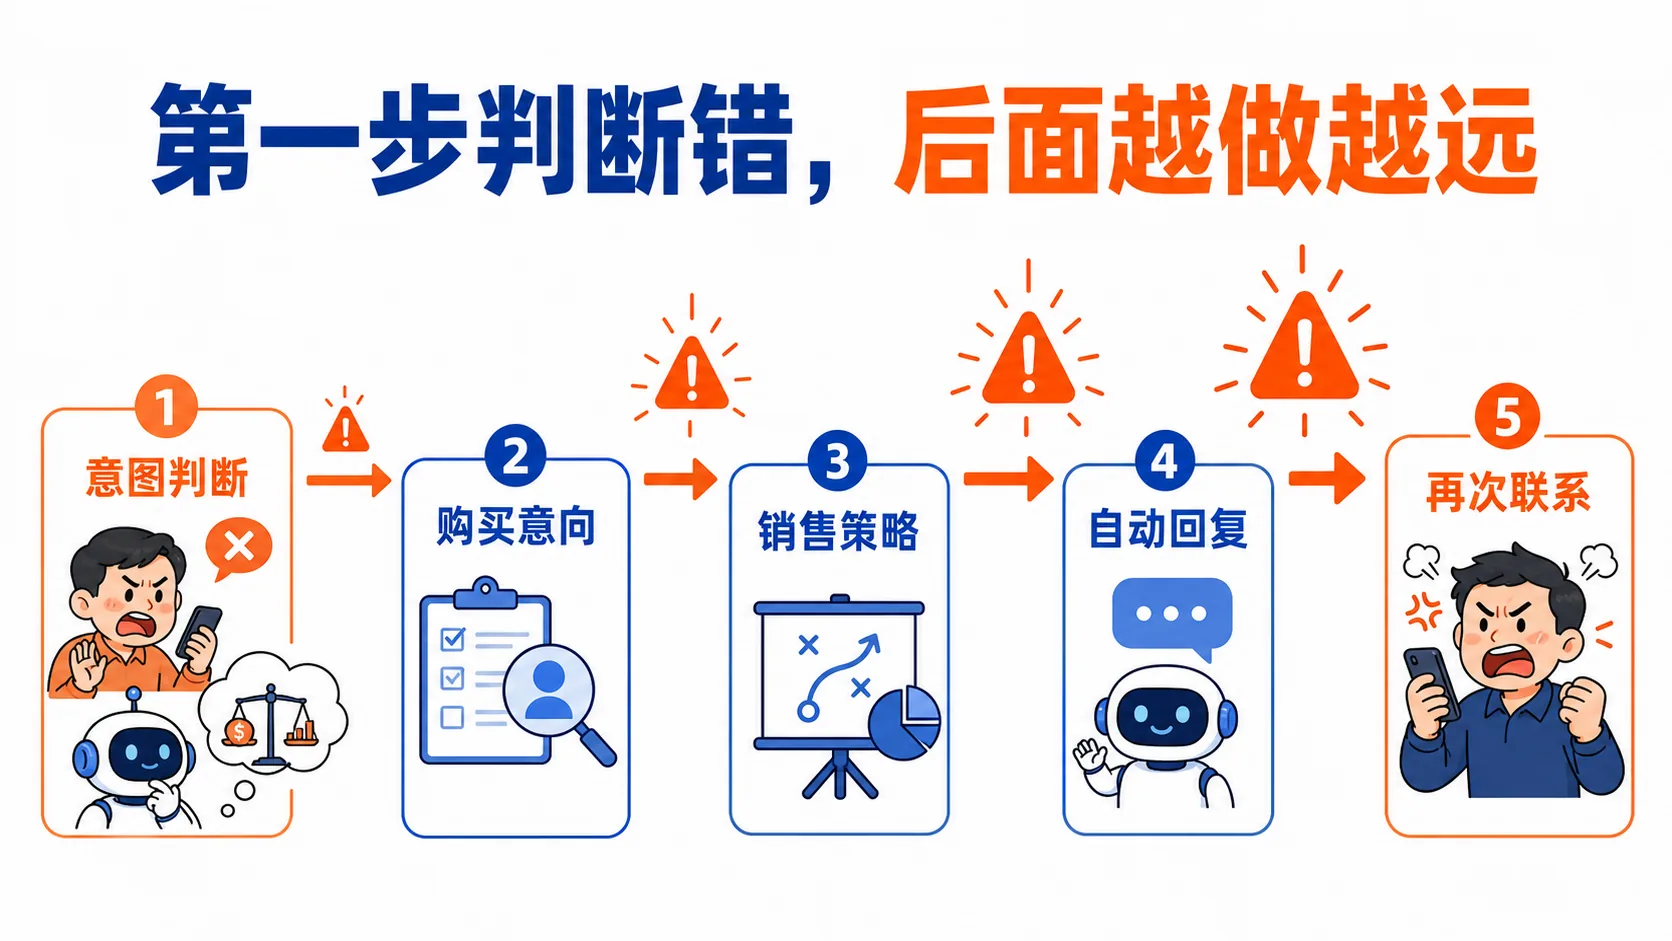
这类故障麻烦在每个局部都能解释。判断意图的模型觉得"嫌贵"符合文本,策略模型拿到比价标签以后推荐优惠也说得通。团队查到最后,很难确定该改哪一段。
研究者把这种现象称为错误级联。上游输出被下游当成事实,后面的步骤会继续补全和强化它。流程越长,定位最初偏差的成本越高。
多 Agent 并不会天然让系统更差。研究、软件开发和复杂分析等任务可以拆成相对独立的部分,多个角色也可能带来帮助。前提是中间结果能够检查,任务失败可以退回到具体步骤。
销售自动跟进的情况不同。第一步意图判断会决定后面所有动作,入口一旦出错,后面的勤奋只会让错误更快传到客户面前。
功能越多,团队越容易相信产品已经成熟
系统不稳定时,团队很自然地继续加东西。
一个模型不放心,就增加复核。一次判断不放心,再加审批和规则。管理页面越做越大,流程图里的箭头也越来越密。
有些控制确实必要。涉及付款、退款、合同和客户触达的动作,本来就需要权限、日志与人工确认。
可团队连正确结果都没有定义清楚时,检查环节也不知道该检查什么。
客户不会因为系统里有五个 Agent 就更愿意付款。他关心销售有没有理解自己的问题。员工也不在意流程用了几个模型,只在意系统能不能少让自己返工。
复杂产品还有一个很现实的副作用。团队投入越多,越难承认最初选的问题可能不值得解决。于是大家继续修界面、调提示词、增加功能,避开那个最便宜也最重要的动作。
去问十个真实使用者,这东西有没有帮上忙。
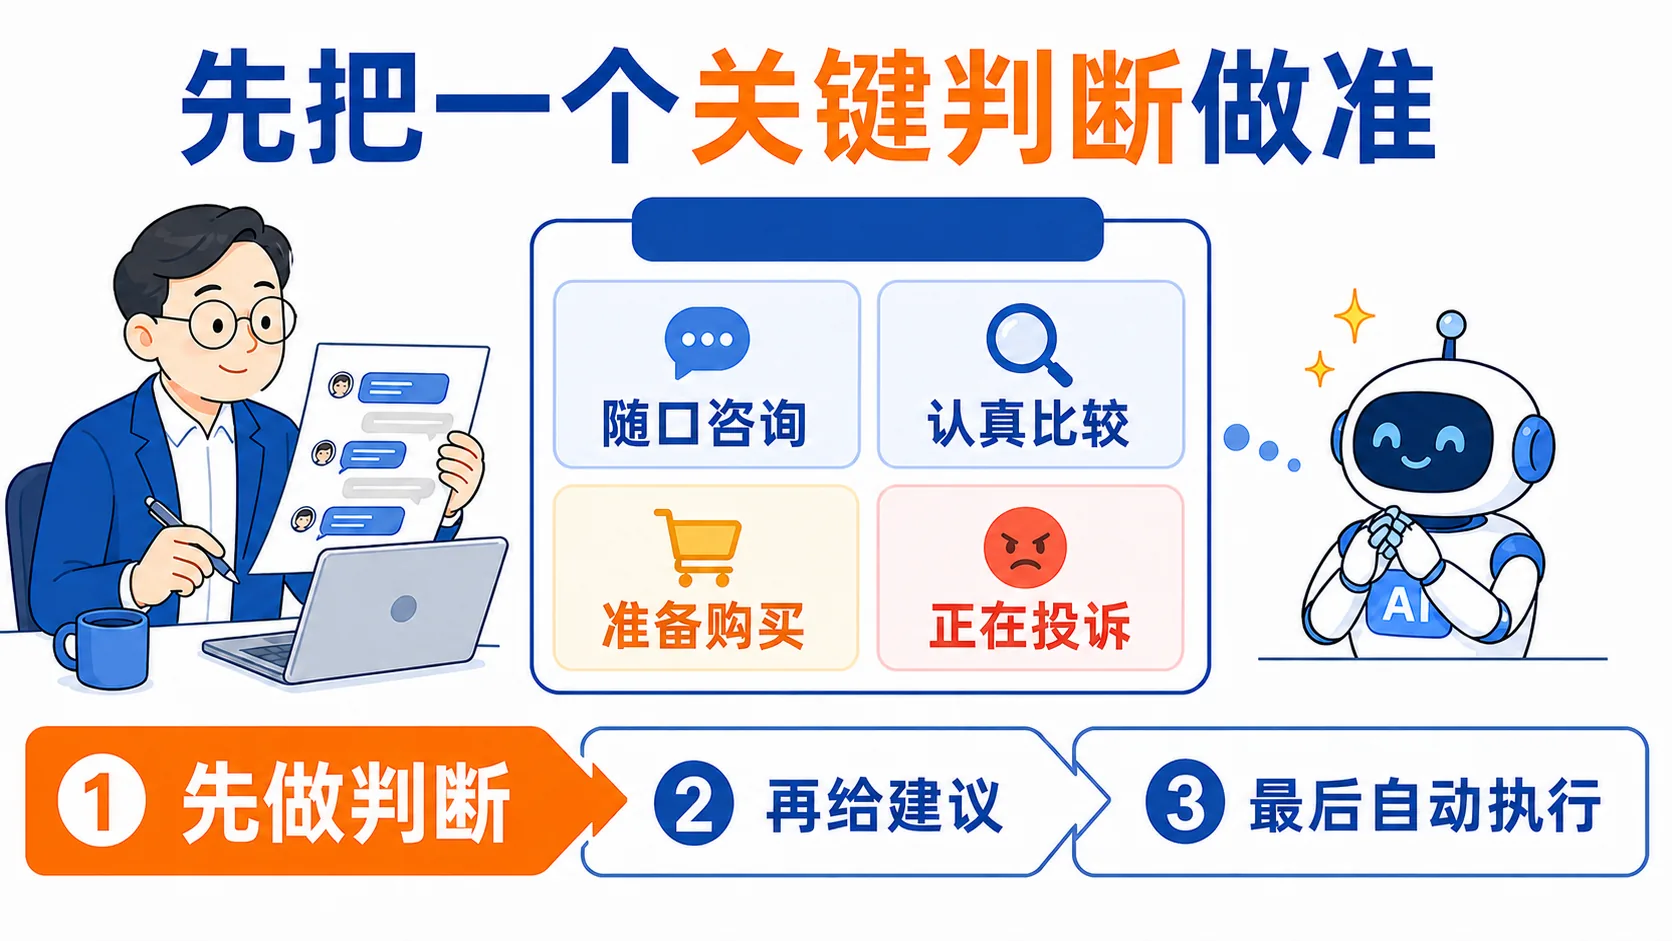
先找出最影响结果的那一次判断
销售工具可以先缩到很小。
暂时不要推荐商品,也别让它直接回复客户。先看系统能否分清随口咨询、认真比较、准备购买和投诉。
分类本身也不要只在团队编写的漂亮样例上测试。从过去的真实对话里抽取失败案例,去掉敏感信息,再让业务人员标出他们认可的答案。
Anthropic 在 Agent 评测指南中给过一个很实用的起点。团队可以先收集 20 到 50 个来自真实故障的简单任务。数量不算大,却足以让讨论从"这个 Demo 很聪明"回到"这些情况它到底做对了多少"。
如果投诉经常被判成购买咨询,先修这个判断。准确度达到业务可以接受的水平以后,再让系统向员工推荐下一步。员工使用一段时间,确认建议没有带来更多返工,才考虑自动生成回复。
每增加一项能力,都应该回答两个问题。
它改善哪个业务结果。出错以后由谁发现并接管。
答案说不清,功能可以先留在演示里。
复杂系统要靠评测长出来
Anthropic 在构建 Agent 的工程经验中建议,先从简单提示开始,用完整评测把它调好。只有简单方案无法满足任务,而且增加步骤能够证明结果更好时,再引入多步系统。
这里的顺序很重要。
团队先有一组真实任务和验收答案,再比较单个模型、固定工作流和多 Agent。复杂架构赢了,就留下。它如果只让流程图更漂亮,测试结果没有改善,就退回简单方案。
评测还要跟着业务变化。促销季的客户表达可能不同,售后政策也会调整。上线后的错例应该进入测试集,成为下一次改动必须通过的题目。
这样做没有大型演示那么热闹。它只是把一个重要判断反复测准,记录失败,再慢慢放开下一步。
可企业购买 AI 产品,最终买的是少犯一次会影响客户和收入的错误。
先让 AI 把那一次判断做对。它稳定以后,更多能力才有地方可长。
参考材料
— 完 —