如果你问一家制造企业:"AI 最应该先做什么?"
得到的答案通常很宏大:智能排产、视觉质检、预测性维护、自动经营分析,甚至让 Agent 直接操作 ERP。
但我最近听到的一个苏州小家电企业实践,起点完全不同。
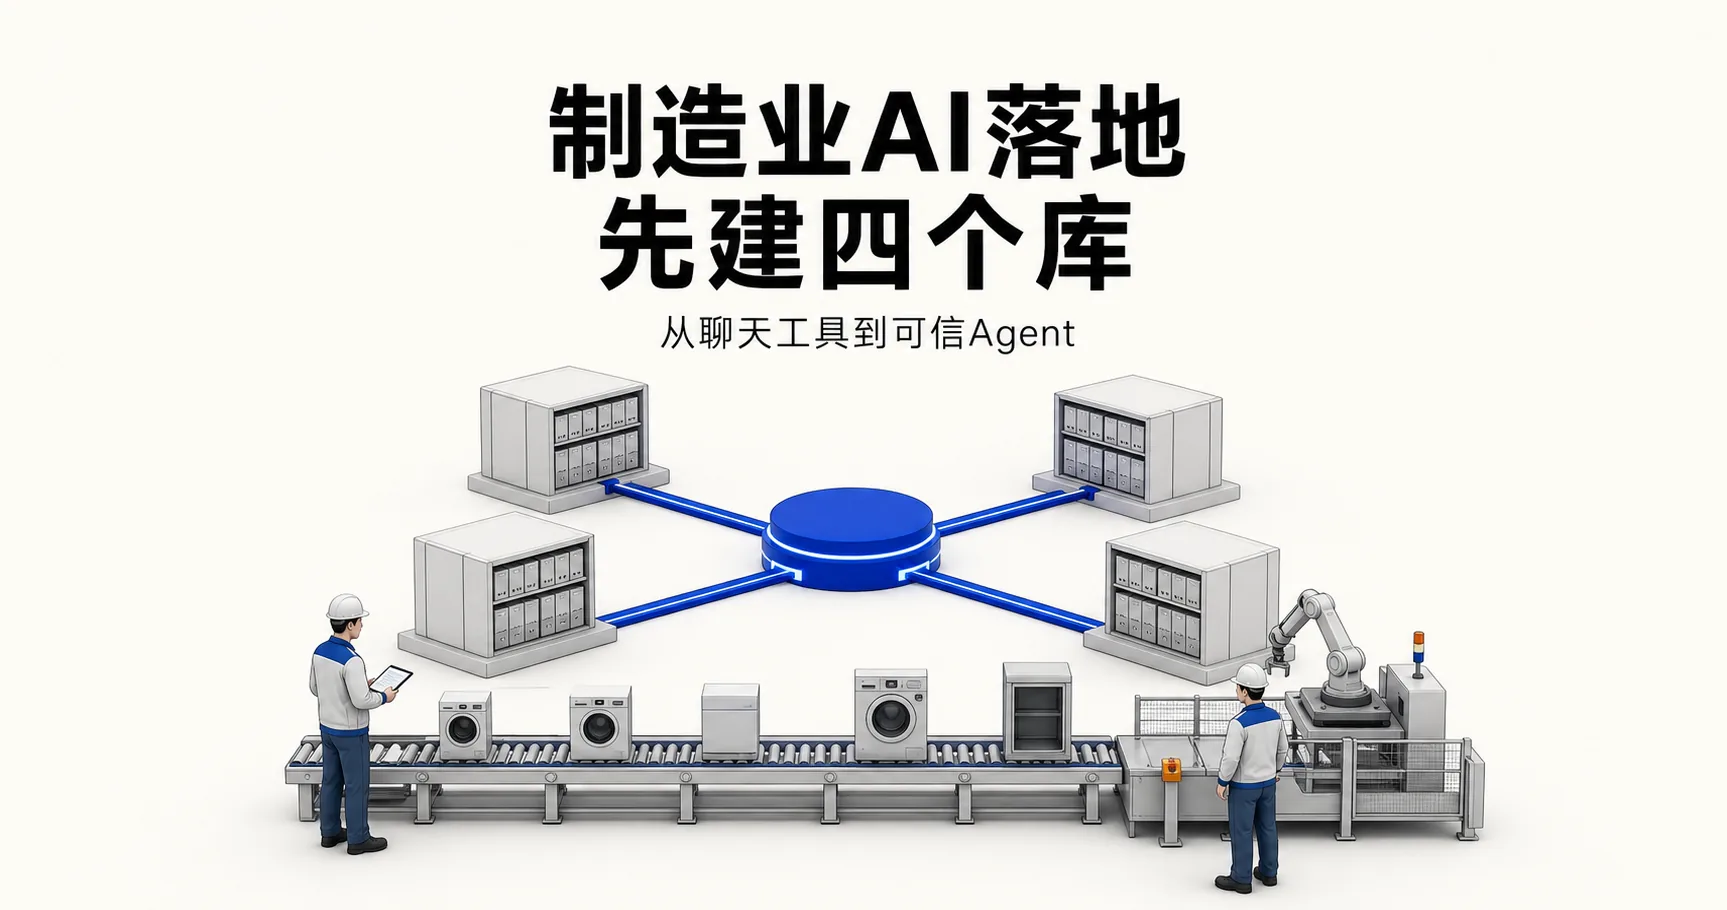
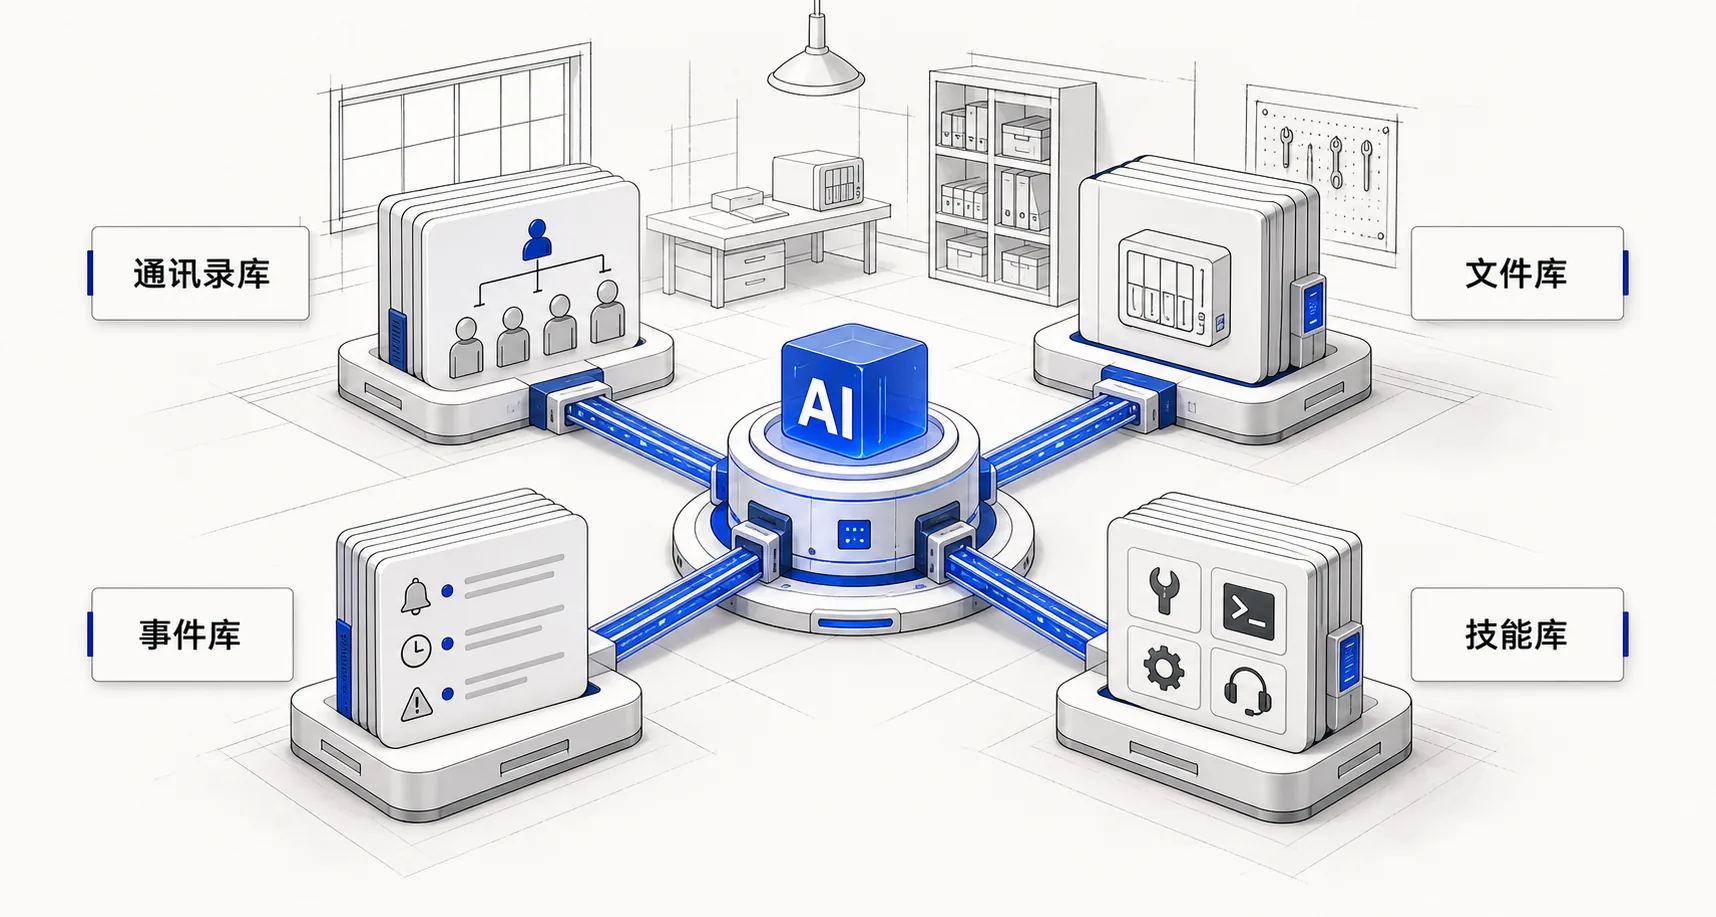
他们没有先讨论模型参数,也没有把所有资料一股脑塞进超长上下文,而是先为企业 Agent 建了四个"库":通讯录库、文件库、事件库和技能库。
听起来不像一场 AI 革命,更像在做信息整理。恰恰是这种"不性感"的工作,决定了 AI 能不能从聊天工具变成真正的生产力。
制造业 AI 的第一个误区:把"会回答"当成"能干活"
工厂里最危险的,并不是 AI 说"我不知道"。而是它用很流畅的语言,把旧版手册、无权文件、过期库存和模型猜测拼成一个看似确定的答案。
制造现场的问题具有三个特点:对象具体、状态变化快、责任边界清晰。同一个零件可能有多个版本;"库存 100 件"不等于"可用 100 件";照片里像某个物料,也不代表可以直接记入 ERP。
工业和信息化部发布的《智能制造典型场景参考指引(2025年版)》,也不是只讲一个"万能大模型",而是围绕工厂建设、研发设计、生产作业、质量管控、设备管理、仓储物流等环节拆分具体场景。
AI 落地不是一次模型采购,而是把一个个业务闭环做实。
"四个库"不是四套数据库,而是四种企业上下文
1. 通讯录库:先回答"你是谁"
它不只是姓名和手机号,还包括人员 ID、部门、岗位、组织关系、仓库和数据权限。Agent 知道"谁在问",才能决定"能查什么、能联系谁、谁有权确认"。
例如,当用户问"今天哪些人加班",真正可行的流程不是让 AI 猜测,而是识别部门范围,向有权限的员工发起确认,回收结构化表单,再形成汇总。难点不在聊天,而在身份、授权、通知、超时和审计。
2. 文件库:让答案回到 NAS 原文
产品手册、工艺文件、质检标准和维修说明往往散落在 NAS 中,而且存在多版本、扫描件和目录继承权限。文件库要保存文件版本、生命周期、ACL、摘要、分块和原文定位。没有证据,就明确拒答。
3. 事件库:让 Agent 记住"发生过什么"
会议结论、异常处置、人员确认和任务状态需要跨会话延续,但不能自动升级为 ERP 权威事实。事件库保存时间线、参与人、来源和状态,并区分会话提取、人员确认与系统事实。
4. 技能库:让"能调用什么"也被治理
查询库存、发送表单、识别图片、生成调拨建议,都是技能。技能库记录工具契约、版本、适用角色、参数约束和审计要求,把 Agent 能力从散乱提示词变成可以审批、测试和回滚的企业资产。
ERP 不是"第五个向量库",而是权威事实源
把这套思路延伸到金蝶云·星空,有一个边界非常重要:不要让 AI 直接修改生产数据库,也不要为了 AI 随意增加生产表字段。
更稳妥的方式是从本地金蝶同步只读数据,在 AI 自己拥有的数据库中增加标签、规则版本、数据质量、同步水位和派生指标;确实需要写回时,再通过经过封装的窄 WebAPI 完成,并逐次确认。
库存尤其适合先做。Agent 可以按组织、仓库和物料汇总现存量、可用量、冻结量和待检量,再给出低库存、负库存、超储和质量待检预警。每条结果都要带数据时点、金蝶来源键和规则版本。
厂商公开案例中的量化收益受企业基础和实施范围影响,不宜直接当成自己的项目承诺。真正值得借鉴的是路径:统一主数据,连接 ERP/MES/WMS,再让 AI 做异常发现和建议,而不是跳过数据治理。
图片识别可以做,但"识别物料"不等于"自动盘点"
员工用手机拍一张照片,Agent 返回物料候选,这个场景可以实现。在受控物料范围内,可以组合条码/OCR、目标检测、垂直分类和相似图片检索。
西门子公开的工业 AI 资料把视觉质量检测、组件追溯、预测性维护列为典型工业场景;世界经济论坛的宁德时代溧阳灯塔工厂案例也提到计算机视觉和深度学习用于质量检测与过程控制。
- 低质量图片和未知类必须允许拒识。
- Top-3 只是预测,人工确认后才能联动库存。
- 检测框数量不能直接当作库存盘点结果。
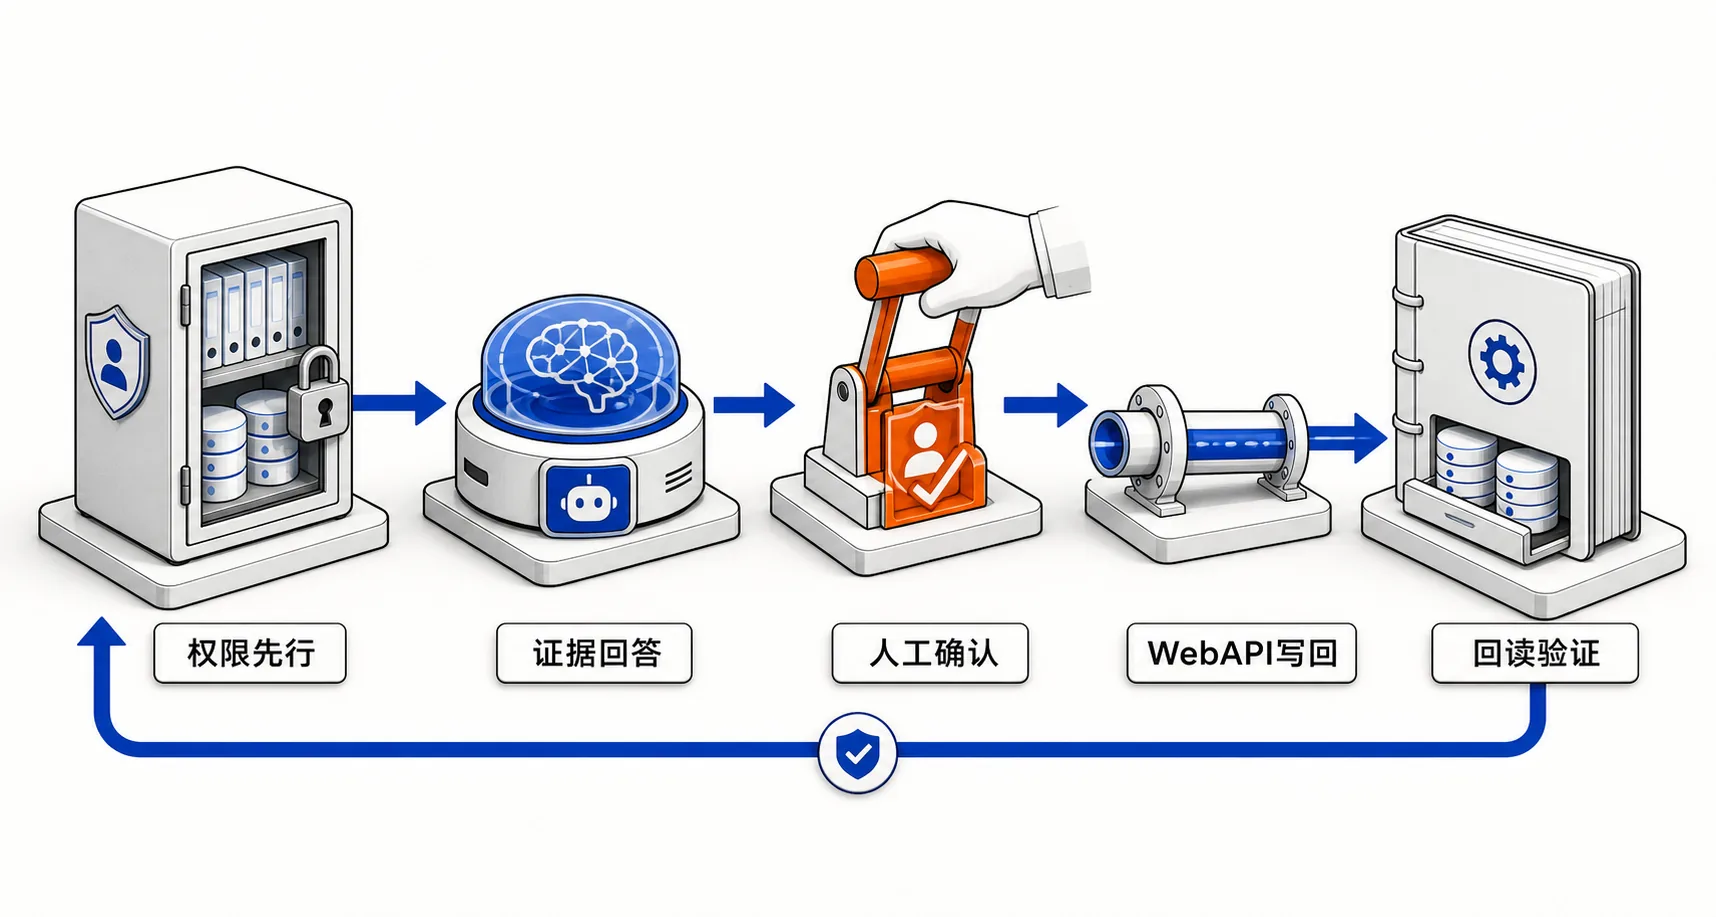
真正可复制的,是一条"可信闭环"
- 选一个高频、低风险、证据明确的场景;
- 先建立身份、权限、来源和数据时点;
- 精确 ID、数量、状态走结构化查询,向量只负责语义召回;
- 预测、派生指标、人员确认和 ERP 事实分开标记;
- 写操作先生成 proposal,展示完整内容和哈希;
- 用户逐次确认后,只允许窄 WebAPI 执行;
- 执行前检查源状态,执行后回读验证并审计。
我们做了一个可运行的开源样板
为了验证这套框架,我们实现了一个本地优先的企业 AI Agent MVP:
- 从 NAS 合成目录检索当前有效产品手册,保留 ACL、版本、章节和来源;
- 从 AI 侧金蝶同步快照查询库存,执行对账、时效门禁和五类预警;
- 使用受控图片样例完成质量门禁、Top-3、未知类拒识、人工确认和库存联动。
项目还包含 PostgreSQL 16 + pgvector、FastAPI、Alembic、OpenClaw TypeScript 工具、中文 Web 演示台,以及默认关闭的 WebAPI 写回安全框架。
当前仓库使用合成数据和模拟适配器,不代表已连接任何真实企业系统。
GitHub:github.com/faint4/enterprise-ai-agent最后
制造业 AI 最容易高估的是模型,最容易低估的是上下文。
企业真正需要的,不是一个"什么都敢回答"的机器人,而是一个知道自己代表谁、依据什么、能做到哪一步、何时必须停下来请人确认的 Agent。
如果你的企业准备开始,不妨先问三个问题:最常查、最容易查错的一类资料是什么?最影响交付的一类库存异常是什么?哪个拍照识别场景即使失败,也能安全地回到人工流程?