Kimi K3 发布后,老板把我叫进办公室:"这个模型挺强。你算算,搬到公司机房里要多少钱?"
网上已经有人替他算好了。
64 张 H200、NVLink、高速网络、液冷、160kW 机柜,再加一年 91 万电费。
最后一行写着:硬件 3000 万,只是起步。
这张账单非常适合转发。数字具体、画面惊悚,老板看完甚至可以当场沉默。
但如果真拿它做采购决策,我建议先撕掉。
不是因为本地部署不贵,而是因为这张账单最危险的地方,恰恰是它看起来太精确。
官方说的是"64 张加速卡",不是"最低 64 张 H200"
先把事实摆正。
Kimi 官方技术博客披露:K3 总参数量为 2.8 万亿,采用高稀疏 MoE 架构,每个 Token 有效激活 896 个专家中的 16 个;权重使用 MXFP4,激活使用 MXFP8。
官方同时表示,为了获得更大的高带宽通信域和更好的推理效率,推荐在 64 张或更多加速卡组成的超节点上部署。
这里有三个关键词:推荐、加速卡、超节点。
它不是"最低配置",也没有指定必须使用 H200。64 张更多是在描述官方希望获得的通信规模、吞吐和工程效率,而不是一道简单的"显存不够就加卡"算术题。
以 MXFP4 粗略估算,2.8 万亿个 4 bit 权重的理论净体积约为 1.4TB;实际部署还要加入量化元数据、运行时开销、KV Cache、激活和冗余。
而 64 张 141GB H200 的显存总量约为 9TB。这已经说明:卡数不是只由权重体积决定的。
模型采用 MoE,也不等于剩下的专家可以不用存。它降低的是每个 Token 的活跃计算量,不会凭空消除模型权重、跨卡路由和通信问题。
那个"91 万电费",算对了,也没算对
原账单的电费公式是:
44.8 × 1.55 PUE = 69.44kW
69.44 × 8760 × 1.5 元 ≈ 91.24 万元
纯数学没有问题。问题出在口径。
NVIDIA 官方给出的 H200 SXM 最大 TDP 确实可到 700W。但 700W 是单张 GPU 的最大热设计功耗,不是整个服务器的功耗。
CPU、内存、NVSwitch、网卡、SSD、电源损耗、风扇或液冷 CDU,全都没有进入 44.8kW 这个 IT 负载基数。
PUE 应该作用于更完整的 IT 设备用电,而不是只给 GPU 功耗乘一个系数,就假装得到了机房总取电。
更明显的矛盾是:同一份清单又写了"单机柜 160kW"。
三个数字都能按公式算出来。区别只是你到底把什么放进了公式。
数据中心成本最容易骗人的地方:公式越精确,越容易掩盖前提没有统一。
真正决定价格的,是四个没写出来的变量
1. 你要跑什么精度?
是官方推荐的 MXFP4 路线,还是为了兼容性采用其他精度?量化方式会影响显存、吞吐、框架支持和效果验证。
2. 你要支撑多少并发?
给 20 个研发人员低频使用,和给 5000 名员工提供全天服务,是完全不同的系统。卡能把模型装下,只代表"能启动",不代表响应速度能被业务接受。
3. 你承诺什么服务等级?
允许每天停机维护,还是要求 7×24 小时?单套集群能运行,不等于生产环境可用。冗余、故障切换、监控和容灾,可能再次抬高资源量。
4. 哪些数据必须留在本地?
很多企业说"必须本地化",真正的需求其实是敏感资料不能外发、审计必须留痕、权限必须隔离。这未必要求把整个 2.8T 模型买回公司。
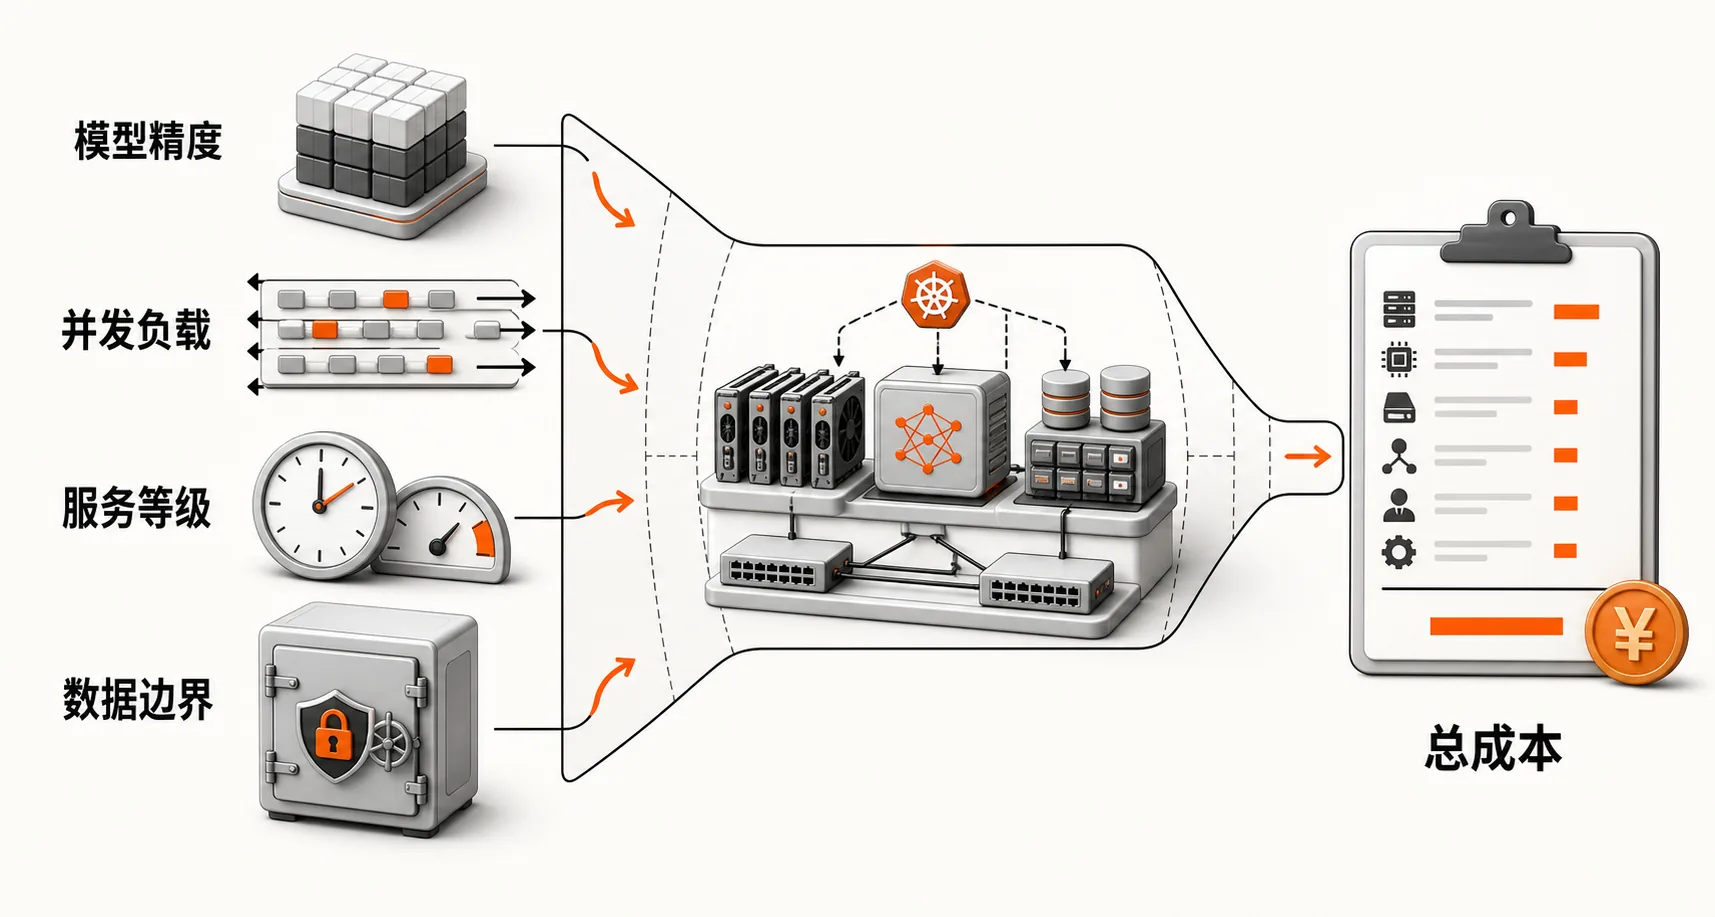
所以,真正的成本公式更接近:
而不是:GPU 数量 × 单卡报价。
3000 万可能不离谱,但不能假装它是标准答案
64 卡高端超节点,加上高速互联、服务器、存储、液冷、供配电、集成服务和备件,做成数千万元级项目并不令人意外。
但"3000 万"必须被标注为方案估算或供应商报价,而不是 Kimi 官方给出的部署门槛。
它会随着加速卡型号、采购地区、交付周期、税费、维保、网络拓扑和冗余等级大幅变化。
更重要的是,硬件只是第一张账单。后面还有推理框架适配、模型升级验证、安全补丁、故障处理、机房改造和 GPU 闲置。
买服务器是 CAPEX。把它稳定运行三年,才是 TCO。
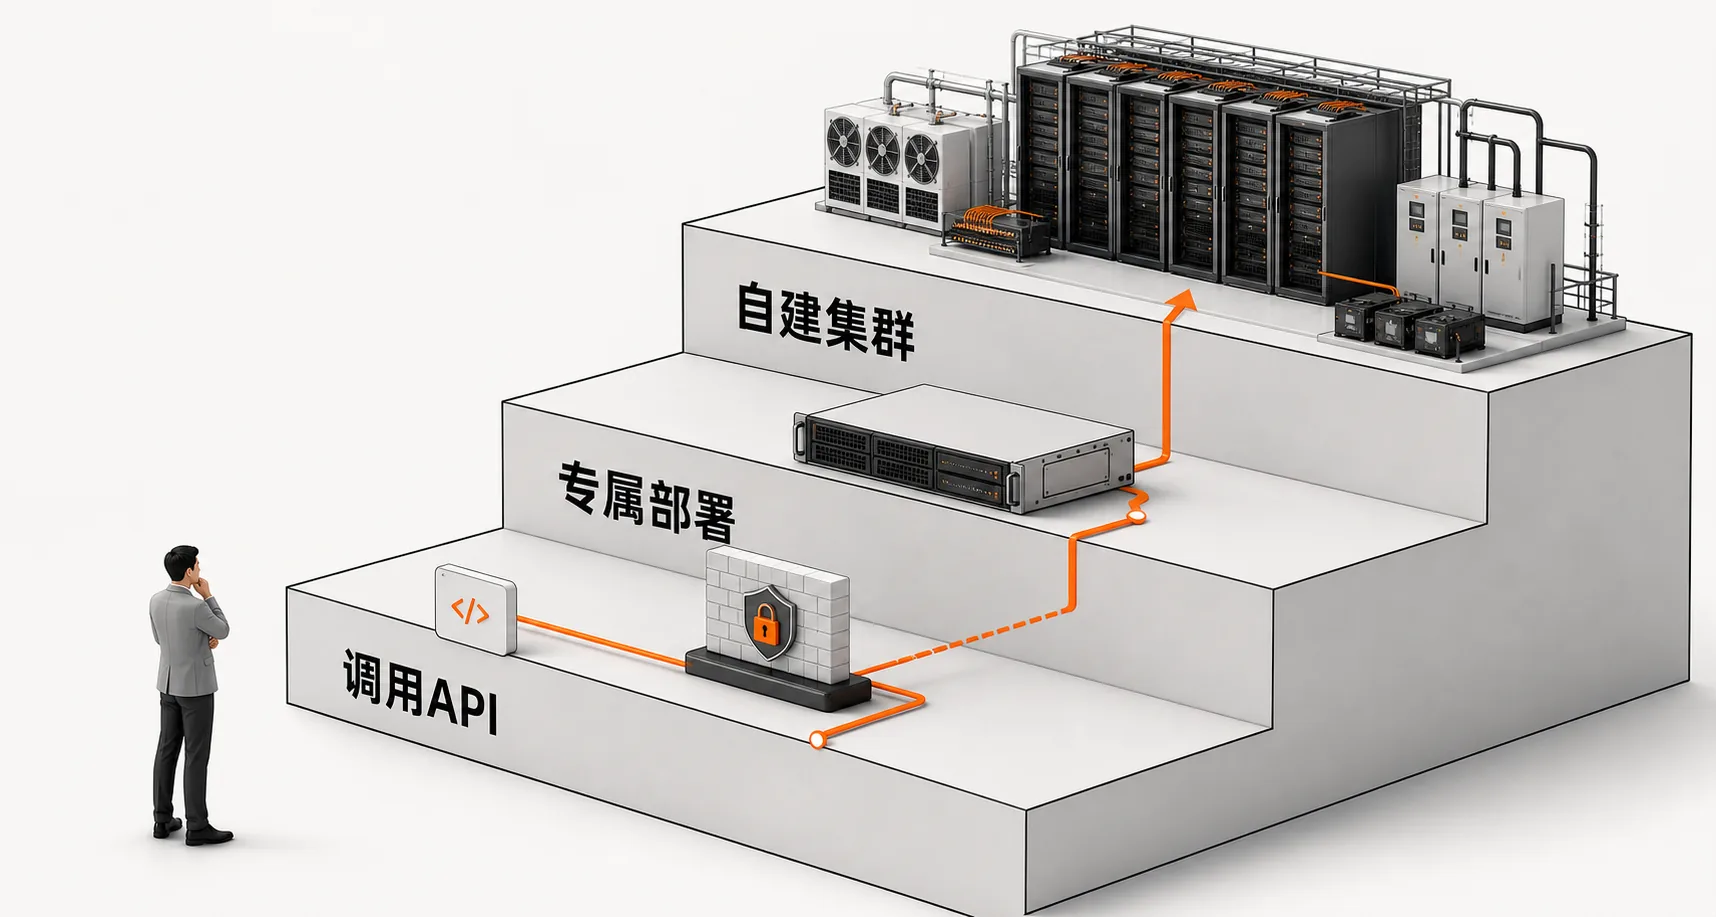
企业真正该比的,是三条路线
Kimi 官方目前同时提供 K3 API。技术博客列出的价格为:缓存命中输入 0.30 美元/百万 Token,未命中输入 3 美元/百万 Token,输出 15 美元/百万 Token。
这不代表 API 一定更便宜。它只是让企业有了一个可测量的对照组。
老板下次再问多少钱,先别急着列显卡
先向他要五个数字:
- 日均输入、输出 Token 和峰值并发;
- 可接受的响应时间与可用性;
- 必须本地保存的数据范围;
- 预计使用年限与增长速度;
- 这套系统每年能创造或保护多少业务价值。
然后分别做 API、专属部署和自建集群的三年 TCO。
如果自建方案只在"全年满载"的 Excel 里划算,而业务真实利用率只有两成,它大概率不是资产,而是一座昂贵的纪念碑。
Kimi K3 的 2.8 万亿参数,确实把开放模型的基础设施门槛推到了新高度。
但它真正提醒企业的,不是"小老板玩不起大模型",而是:本地化部署不是一次硬件采购,而是一项需要被业务负载证明的长期经营决策。
真正成熟的老板,不会被 3000 万吓退,也不会被"数据安全"四个字催着下单。
他会先问:我们究竟为什么必须拥有它?