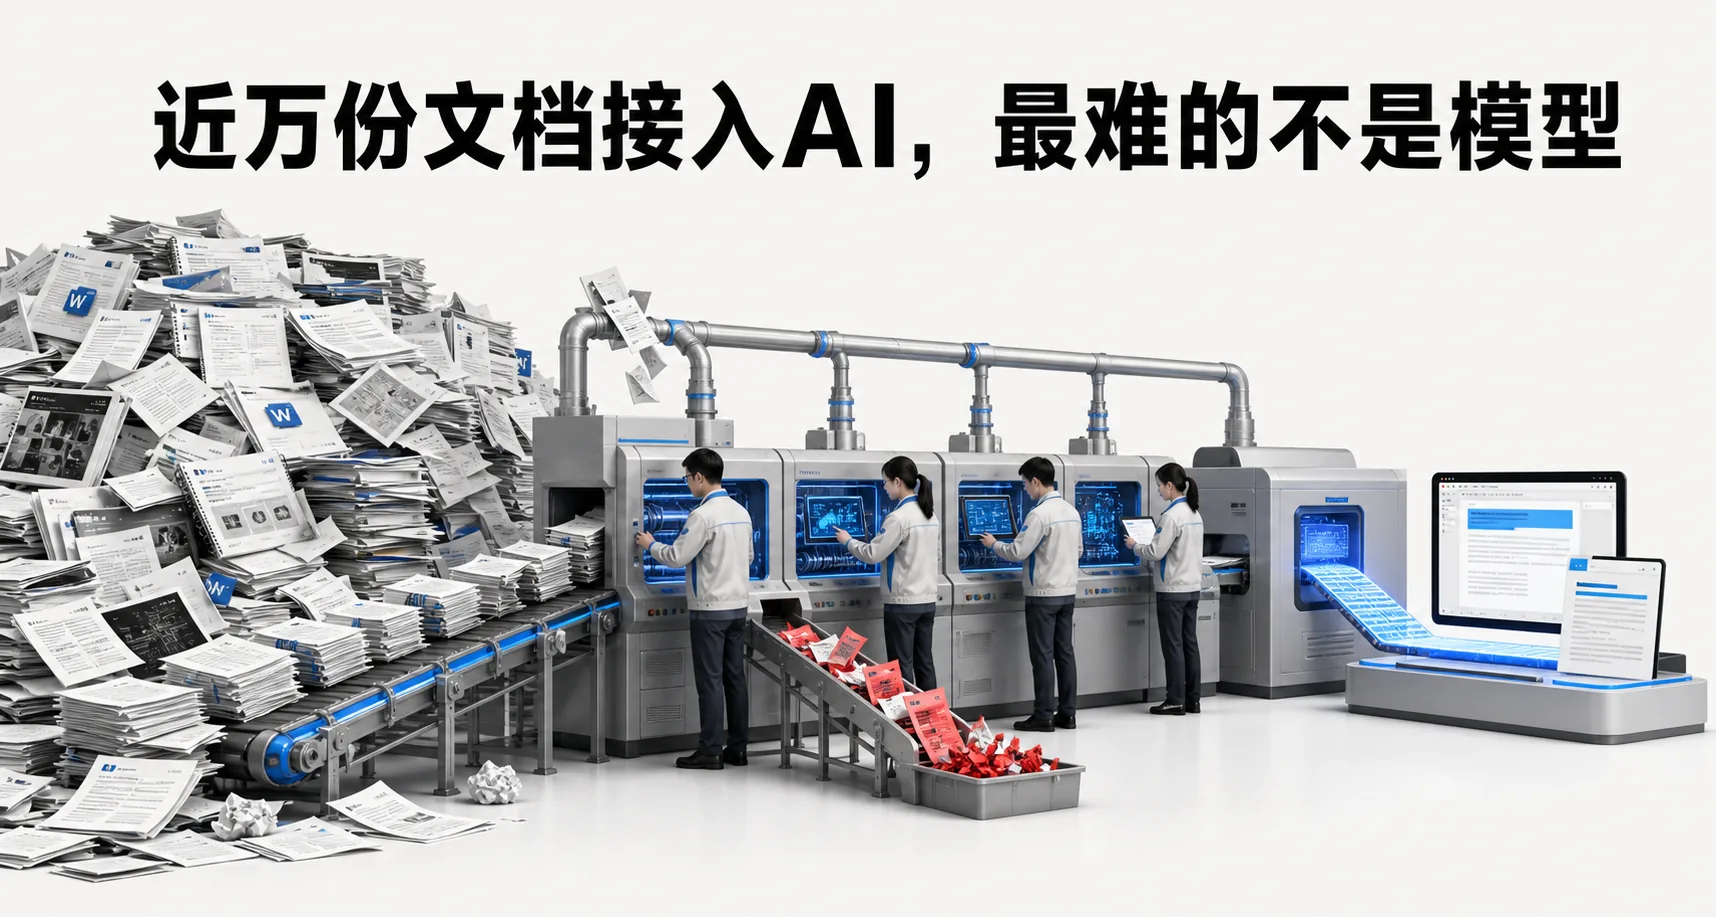
项目启动时,目标听起来很简单:把散落在 Confluence、Word、Markdown 和内部论坛里的技术资料统一接入大模型。
以后技术同学遇到问题,不用翻十几个目录,也不用在群里等待老员工回复。
我们一开始估计,一两周应该能跑起来。
确实,一两周以后,Demo 能问答了。
但直到四个人前后投入近三个半月,系统才真正具备部门级使用的条件。
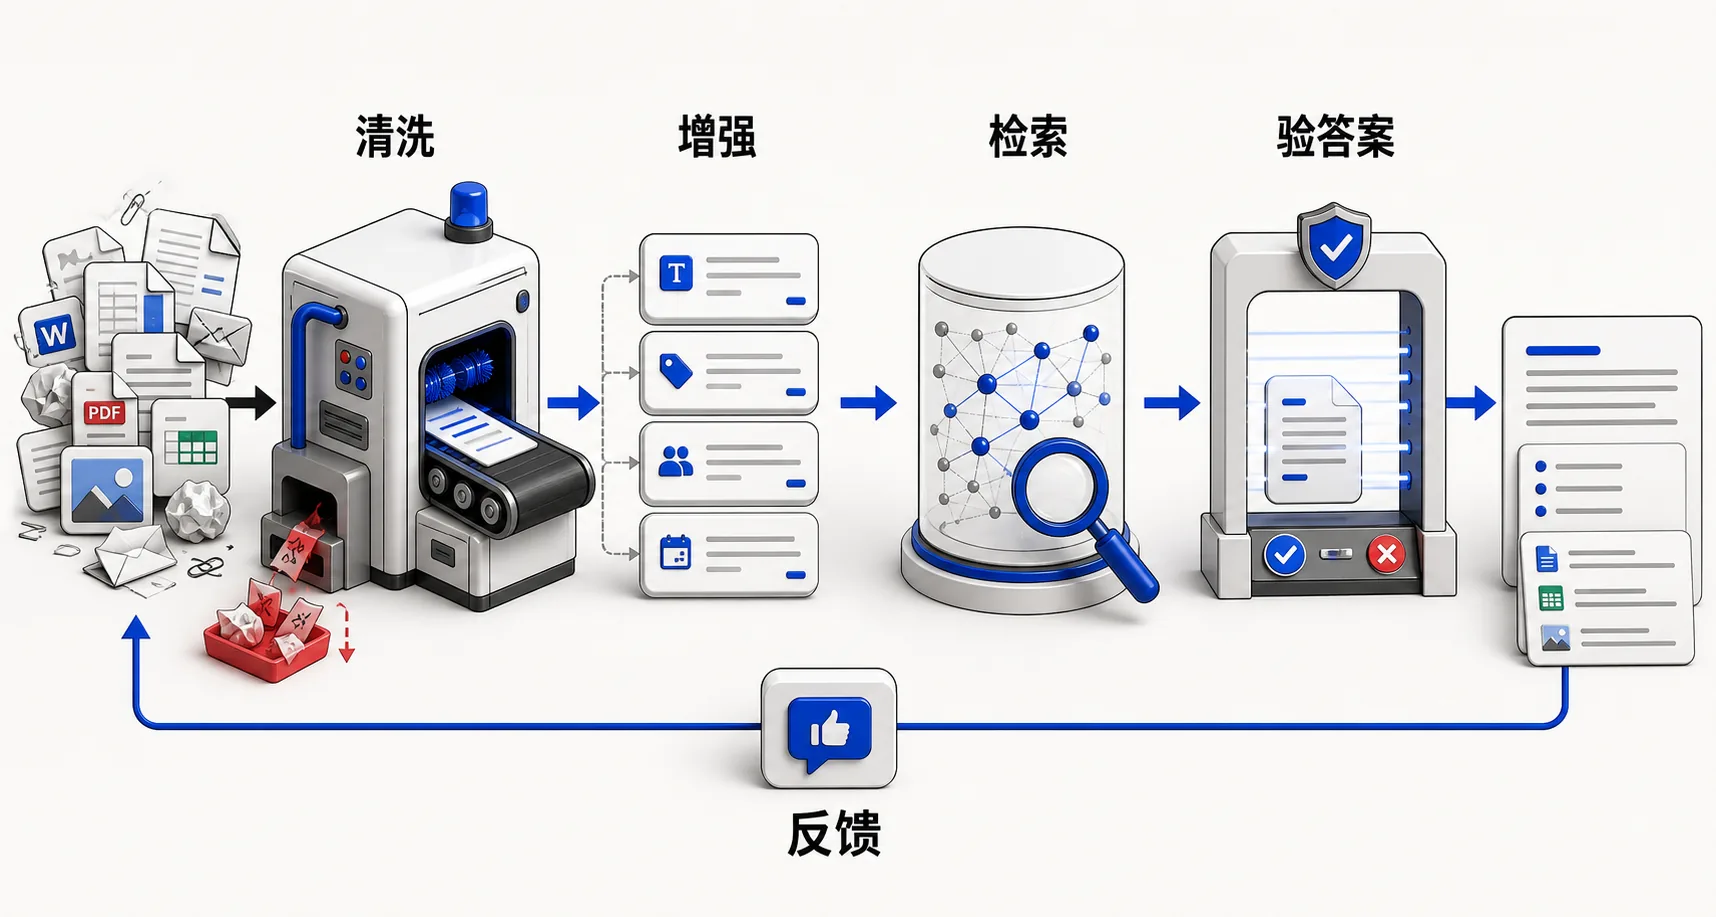
企业知识库有五次危险的错觉:以为清洗完了、以为入库完了、以为搜到了、以为能返回文字就够了、以为上线就是结束。
以下数字来自本次项目复盘口径。真正值得复用的,不是某个固定参数,而是每一步如何判断"真的完成了"。
第一次错觉:文件能打开,就等于数据能使用
盘点之后,我们找到 8600 多份文档。97% 在 5000 字以内,少量超长文档接近 3 万字;还夹着 3700 多张图片。
真正麻烦的不是格式多,而是噪音已经和知识长在了一起:
- 页面 ID、上传时间、下载次数和编辑记录;
- "上次编辑者"一类尾注;
- 浏览器兼容提示和附件下载提示;
- 论坛回复区标记、纯数字行和失效链接;
- 同一制度的多个历史版本。
这些内容直接进入向量库,系统不一定报错。它只会在用户提问时,安静地返回一堆看起来相关、实际毫无价值的结果。
我们先抽样 50 份,让大模型辅助识别重复噪音模式,再把稳定模式沉淀为清洗规则。全量运行、人工抽检、补规则,再运行。
这个循环做了五六轮,累积 40 多条规则,脚本迭代三十多个版本。最终回看,数据清洗占了项目约 65% 的工时。
我们还为每份文档保留两种产物:Markdown 版本供机器切分入库,格式干净的 Word 版本供用户查看引用原文。
机器吃什么,和人看到什么,不必是同一个文件。
第二次错觉:文档入库了,AI 就知道它能回答什么
清洗后的元数据只有文件名、目录和分类。但用户不会按照文件名提问。
他会问"MQTT 怎么配置",真正的文档却可能叫《数据采集通讯模块使用说明》。
我们让大模型为每份文档补充三类语义元数据:
- 一句话摘要;
- 5—8 个关键技术术语;
- 3—5 个"这份文档能够回答的问题"。
用户的问题和预生成问题往往属于同一种语言,而文件标题属于归档语言。把知识从"文件叫什么"改写成"它能解决什么",检索才开始接近真实使用方式。
但入库阶段还有一颗很贵的雷:项目中途把 Embedding 维度从 768 改为 1024 后,原有 collection 不能继续使用,8600 多份文档必须重新向量化和入库。
从那以后,我们把 Embedding 模型版本、向量维度、清洗规则、分块策略、内容哈希和入库时间写进数据契约。
第三次错觉:检索命中了,答案就一定在上下文里
系统上线前出现过一个特别反直觉的 Bad Case:日志明明显示正确文档已被召回,大模型却回答"未找到相关信息"。
排查后发现,为每个切片附加的全文摘要与大量泛化问题高度相似,长期占据 Top-K;真正包含配置参数和表格的正文切片,反而被挤到了截断线外。
系统"搜到了正确的文档",但没有把"包含答案的那一段"交给模型。
最后我们采用父子文档式的连带召回:先找到高相关切片,再用文档标识拉回相关兄弟切片,按顺序重组后交给生成模型。
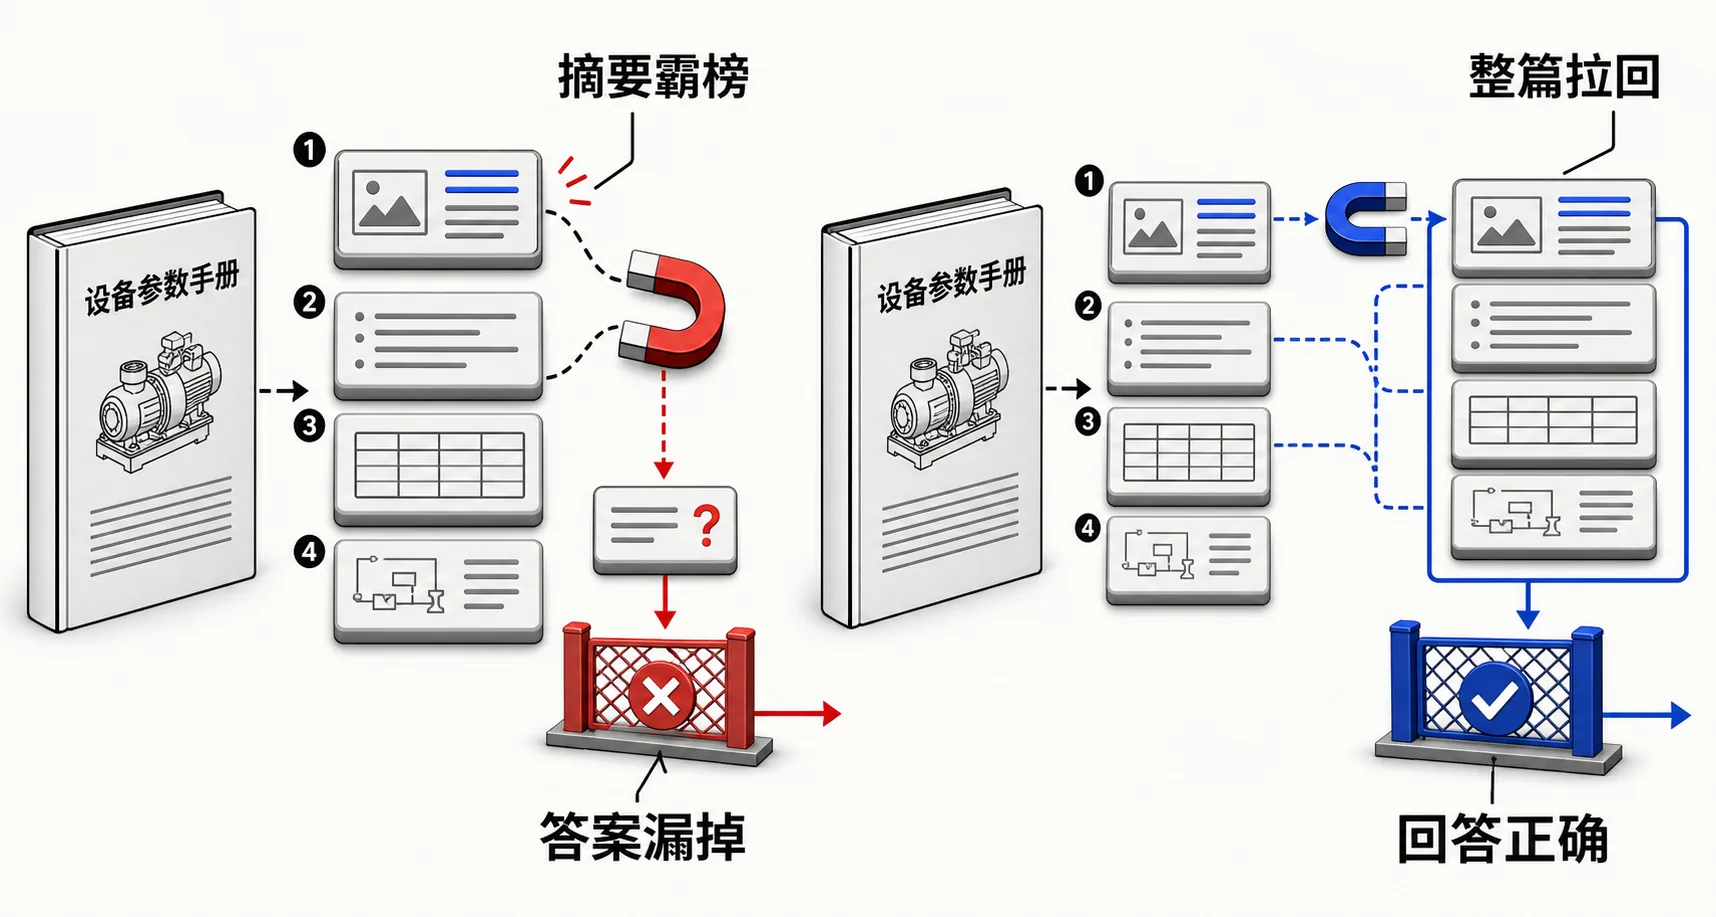
这不代表所有命中都要拉回全文。超长手册仍需控制上下文预算,可只扩展邻近章节或采用章节级父子索引。
第四次错觉:参数越大,效果越好
我们从真实问答中整理了 300 个代表性问题,并标注正确答案来自哪份文档。
案例评测中,Top-5 向量检索配合连带召回,Recall@5 达到 94%,300 个问题命中 282 个;加入 Rerank 后达到 99.3%,命中 298 个。
但第一次对 Top-50 候选重排,单次请求耗时达到 12.6 秒。准确率很好,用户体验已经死了。
回看评测发现,大部分正确答案本来就在 Top-20。把重排候选从 50 降到 20 后,耗时降到约 2.8 秒,召回仍保持在 99% 以上。
这不是证明"20 是最佳参数",而是说明生产系统必须同时看三张表:
- 召回是否足够;
- 延迟是否可接受;
- 多出来的准确率是否值得计算成本。
企业不是在参加模型比赛,而是在交付一段可用的业务体验。
第五次错觉:能返回文字,就完成了知识问答
技术文档里有 3700 多张截图。界面操作、报错现场、接线方法和架构关系,很多时候一张图比五段解释更有效。
POC 阶段,我们把图片转成 Base64 塞进响应。它能工作,但体积膨胀、难以缓存,响应也变得笨重。
MVP 阶段改为对象存储:清洗时提取图片、生成稳定地址并建立映射;回答返回前转换图片引用;浏览器负责缓存,存储层可以独立迁移。
另一个关键问题是引用。答案如果不能让用户点回格式完整的原文、看到版本和上下文,就很难建立信任。
真正的知识库,是上线后才开始学习
我们在消息数据中记录原始问题、改写问题、召回文档与分数、各阶段耗时、用户反馈和最终引用。
用户每一次点踩,都是一条免费的 Bad Case 标注。
但只有把问题、召回证据、回答和反馈串在一起,这条标注才有用。只记录"用户不满意",团队仍不知道错在数据、检索、生成,还是文档已经过期。
三个半月之后,我们重新定义了"项目完成"
一套 RAG 系统能回答问题,不代表企业知识库已经完成。我们现在会用六个条件验收:
- 可追溯:每个答案能回到原文、版本和证据;
- 可拒答:没有足够证据时,不自信补全;
- 可评测:有固定问题集、Recall、正确率和延迟基线;
- 可更新:新文档、变更文档和失效文档可增量处理;
- 可治理:权限、有效期、责任人和冲突规则明确;
- 可迭代:Bad Case 能定位到链路环节并进入修复队列。
至于是否使用 LangChain、LlamaIndex,或者选择哪一种向量库,反而排在后面。
框架适合快速验证,长期运行则需要足够的可观测性和链路控制。你可以用框架,也可以自建,但必须能回答:
这一条错误答案,究竟在哪一步变坏的?
最后
近万份文档接入大模型,最让人意外的不是工程量大。
而是系统越接近生产,模型在项目中的存在感反而越小。
真正决定结果的是:文档是否干净,知识是否有效,证据是否完整,评测是否持续,错误是否有人修。
开源 RAG 框架让知识库 Demo 变得很容易。但企业最终购买的,不是一个能聊天的搜索框。
而是一套持续回答三个问题的知识生产线:这条知识从哪里来?现在还有效吗?答错了怎么修?
如果你的知识库已经上线:最近 30 天的错误回答中,有多少条已经定位到具体文档和具体链路环节?
如果没有答案,系统可能只是"能用",还远没有进入"可信"。