企业暗知识 · 知识库 · 测试工程
公司最贵的知识,往往只活在员工嘴里
会议录音只是来源。企业要留下的,是经过确认、带着出处、条件、责任人与有效期的决策记忆。
制度写了“怎么做”,系统记了“做完没有”。决定结果的那部分,常常藏在一句没被记录的话里:这次为什么例外?当时为什么这样判断?出了问题先找谁?
前段时间,我看到一组很有意思的数据。
据飞书公开案例,2025 年上半年,小鹏汽车生成了超过 63 万份 AI 会议纪要,平均每天接近 3500 份。对一家大型企业来说,比“开了多少会”更值得看的,是那些原本会后就散掉的讨论,开始有机会留下来。
企业知识管理做了很多年,资料通常并不少:制度、流程、产品手册、测试用例、故障单、项目文档,一层层堆在网盘和系统里。可一到具体问题上,大家还是会说:
“这个要问老张。”
“当时情况比较特殊。”
“群里好像讨论过,你往前翻翻。”
如果一家公司离不开这些话,它缺的未必是文档。它缺的是那些没有进入系统、却一直在左右判断的“暗知识”。
系统记住了结果,却丢掉了为什么
拿测试工作来说,一次缺陷争议最后可能只留下几个字段:已确认、不修复、延期、降级处理。
可有价值的信息,往往发生在状态改变之前:为什么认为风险可接受?哪个客户场景不会被影响?依赖了哪一版设计?谁提出过反对意见?如果流量增加三倍,原来的判断还成立吗?
这些内容通常存在于评审会、电话、群聊和老师傅的口头解释里。会议结束,测试平台只收下结论,判断过程就跟着散了。
过几个月,新人接手项目,又得把产品、研发和测试重新拉到一个房间里。大家并非在解决新问题,只是在重新拼回旧上下文。
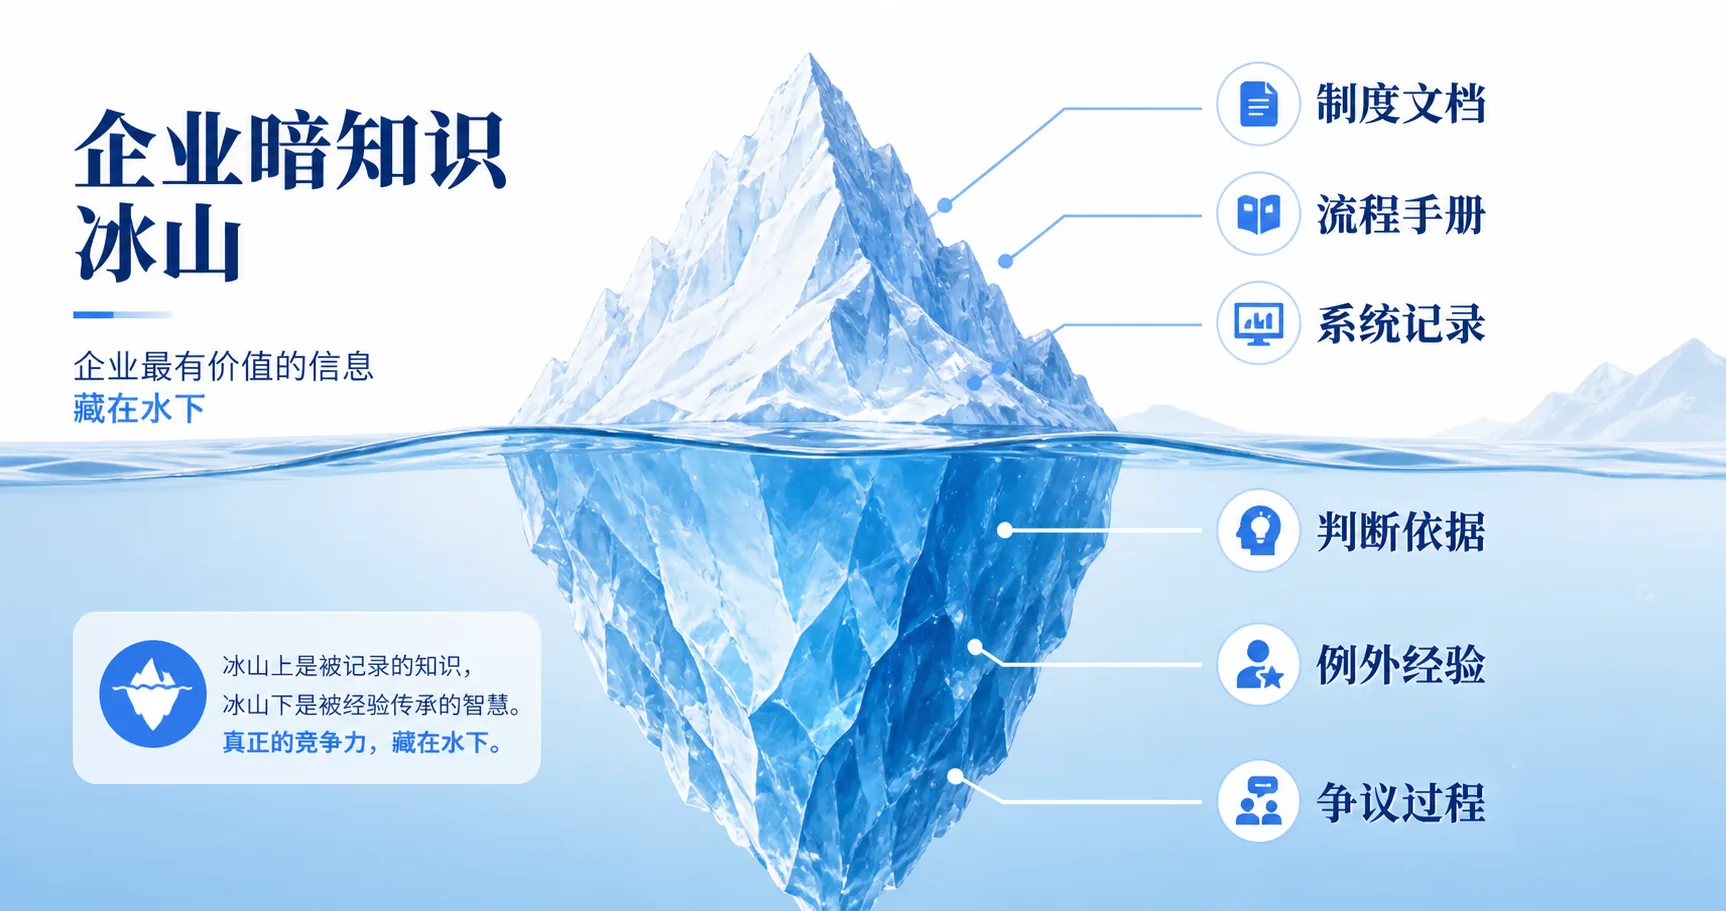
企业里常见的暗知识,大致有四种:
• 判断依据:什么信号出现时,经验丰富的人会改变结论。
• 例外条件:制度写的是 A,但遇到某类客户、设备或合同,要走 B。
• 失败记忆:过去试过什么,为什么没成,哪些坑不能再踩。
• 关系与责任:谁有权拍板,谁负责复核,出错后要升级给谁。
它们不够整齐,也很难靠填表一次收集完。可一家公司能不能稳定交付,靠的恰恰是这些细节。
把会议录下来,不等于建好了知识库
录音和转写只是第一步。
一份两小时的会议转写里,会混着重复表达、临时猜测、被推翻的观点和与议题无关的闲聊。有人说“应该没问题”,十分钟后又补充了三个前提。如果把整份转写直接塞进知识库,员工以后搜到的,可能是一个已经作废的中间意见。
还有更麻烦的情况。会议里涉及客户信息、员工评价、未发布产品和内部权限。能参加会议,不代表内容可以被全公司检索。模型能把话转成文字,却不能替公司决定谁有权看、哪句话可以成为规则。
所以,录音文件只应作为来源。需要进入知识库的,是经过确认的“决策知识卡”。
一张能被复用的知识卡,至少应写清楚:
1. 当时在处理什么问题:业务对象、项目、设备或缺陷编号是什么。 2. 最后作出了什么决定:接受、拦截、延期、降级,还是升级处理。 3. 依据来自哪里:数据、测试结果、制度条款、客户反馈或历史案例。 4. 决定适用于什么条件:版本、地区、客户类型、时间范围和触发阈值。 5. 有哪些例外:哪些情况不能照抄这次结论。 6. 谁确认了这张卡:业务负责人、测试负责人或合规人员。 7. 什么时候需要重审:规则更新、产品改版或数据变化后,旧结论是否失效。
这七项补齐,一段讨论才从“有人说过”变成“可以查证、可以复用,也可以推翻”的企业知识。
一套能落地的做法:先抓住最容易重复的讨论
不必一上来录下全公司的每一句话。先挑那些经常重复、结论会被再次使用的会议,比如需求评审、缺陷争议、线上复盘、回归分析和客户反馈会。
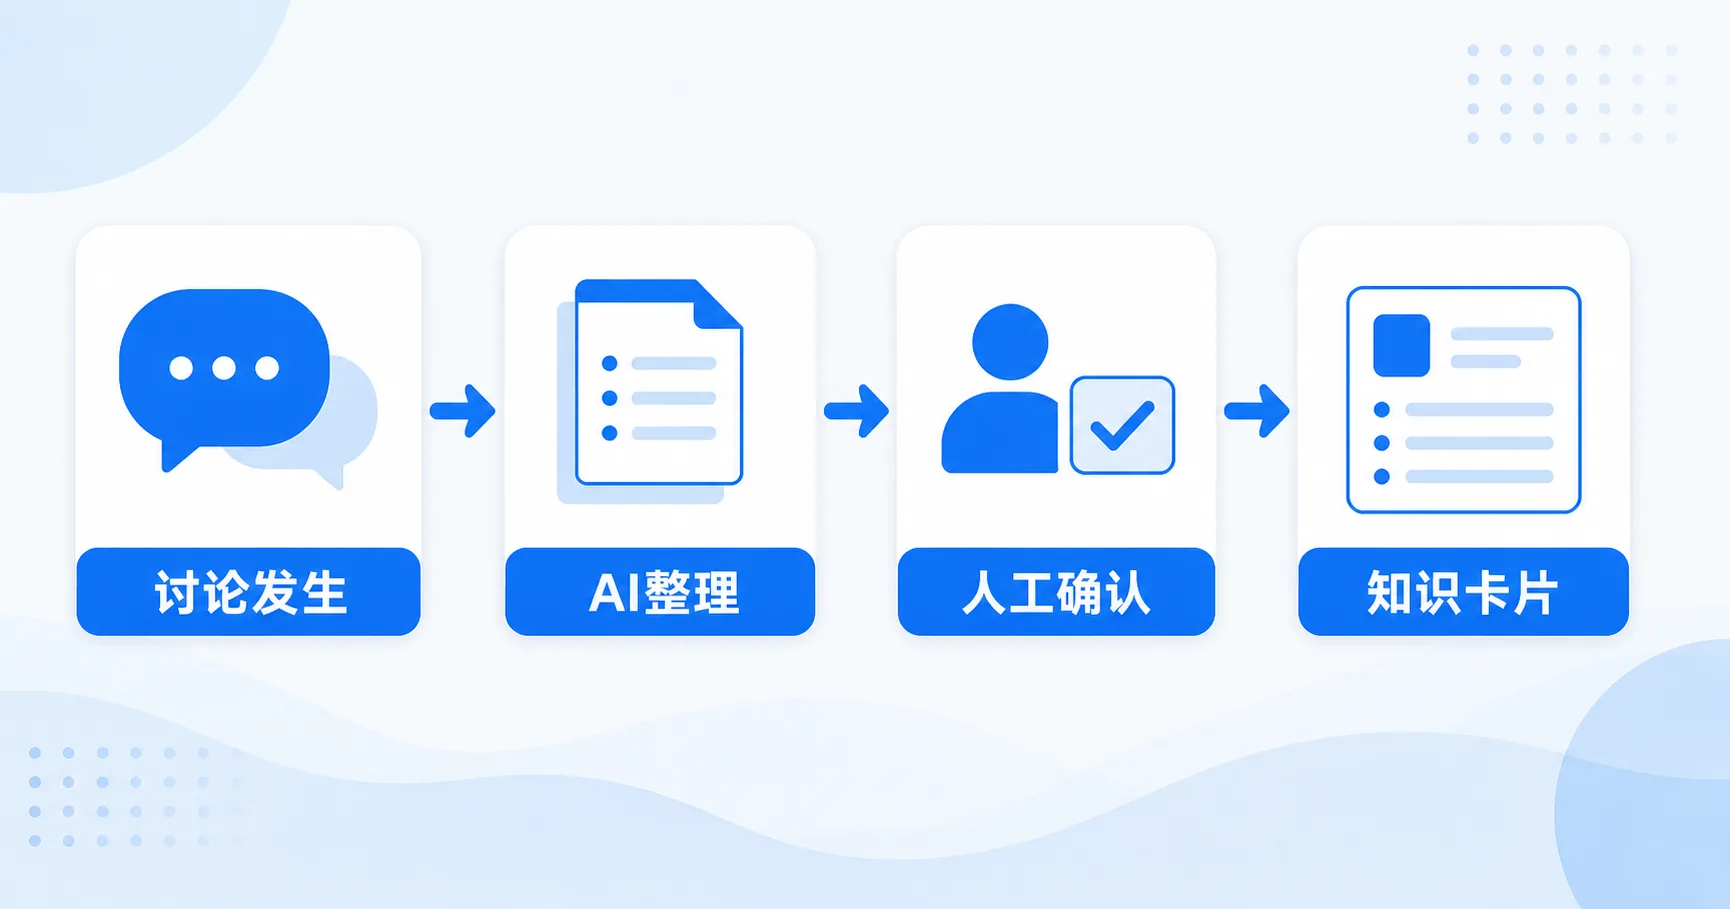
第一步,保留原始来源。
录音、转写、会议时间、参与人和关联任务编号放在一起。这样做是为了让后来的人能回到原始语境,不是为了方便“监听”。录制前要告知参与者,并按现有权限控制访问范围。
第二步,让 AI 整理候选知识卡。
AI 可以从长讨论里提取结论、证据、分歧、例外和待办,把同一议题散落在几十分钟里的内容拼在一起。它适合做整理员,不适合做最终批准人。
第三步,由当时的责任人确认。
负责人需要检查:结论有没有被截断,适用条件是否完整,反对意见是否被遗漏,哪些内容只是猜测。确认后再进入可检索区域;未确认的内容,只能标记为会议记录。
第四步,把知识卡挂回业务对象。
测试团队可以把知识卡关联到需求、缺陷、用例和版本。下一次出现相似问题,员工搜到的不只是文字相似的片段,还能看到当时对应的产品版本、处理结果和责任人。
搜到历史答案,还要先问一句:它现在仍然有效吗
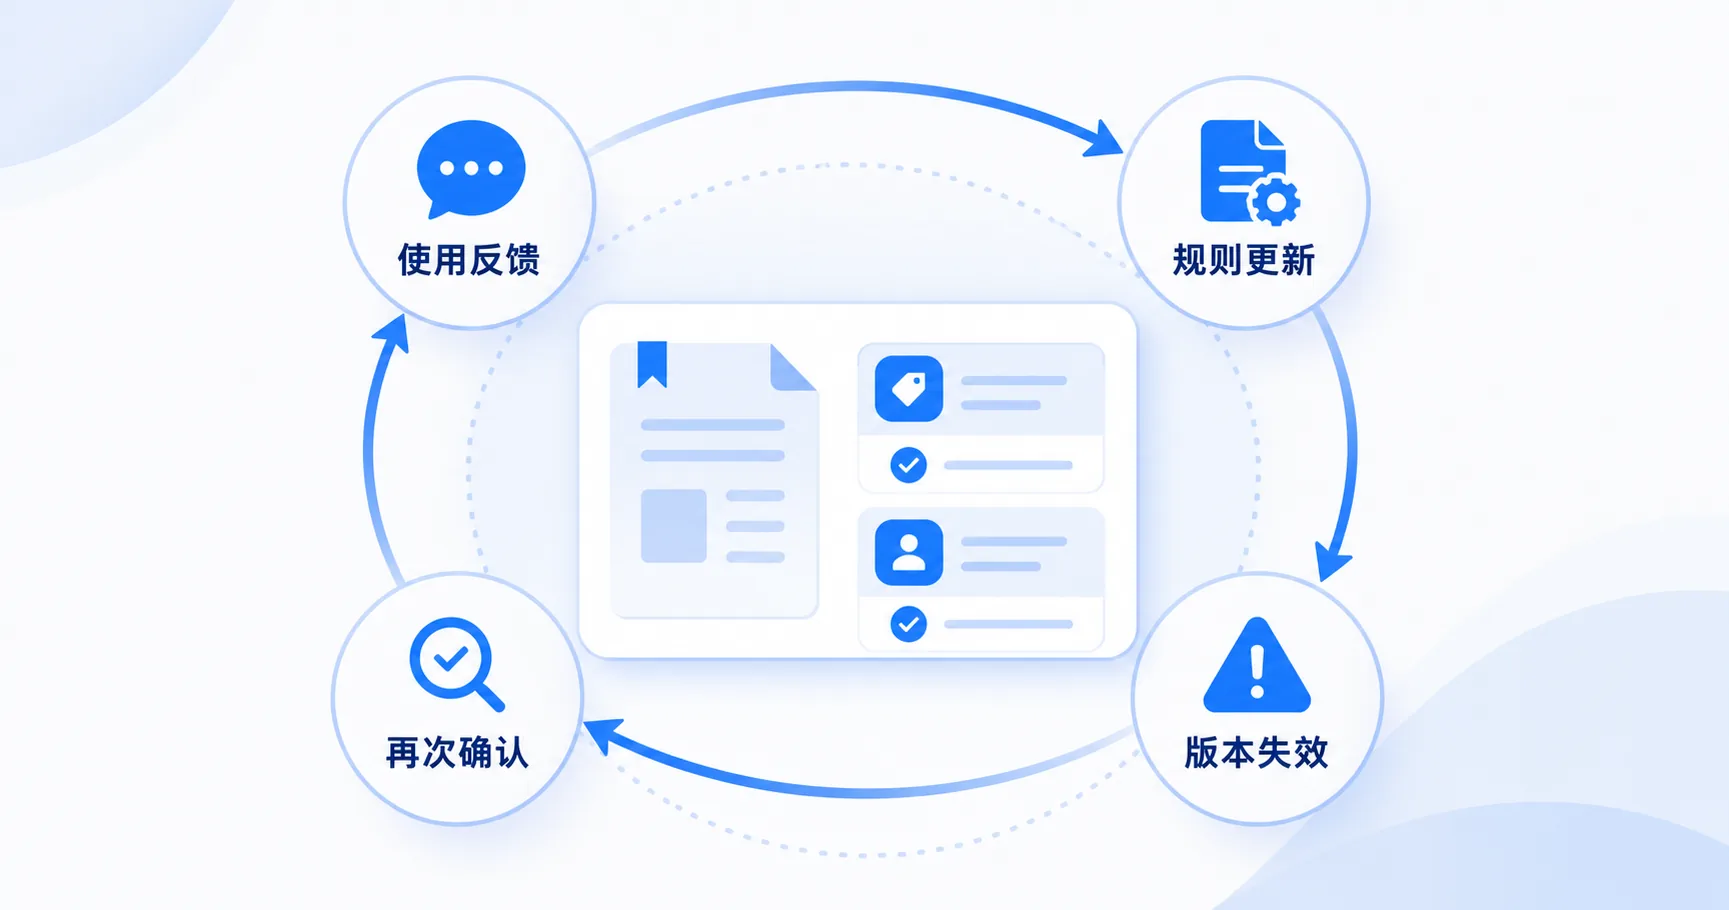
暗知识进入系统以后,另一个问题马上出现:过去的正确经验,今天可能已经错了。
产品改版了,旧的降级方案不再适用;供应商换了,原来的质量判断失效;监管规则调整了,曾经可接受的处理方式需要重审。如果知识库只负责增加内容,不负责淘汰内容,它迟早会成为一座更难辨别真假的资料山。
因此,每张知识卡都应有版本、确认人和复查条件。员工使用后发现不适用,要能标记原因;同类反馈达到一定数量,触发规则更新;关联对象发生版本变化,旧卡自动进入待确认状态。
这里有个容易忽略的边界:AI 给出的回答,应当同时展示来源、形成时间和适用条件。它可以提示“2025 年 3 月的项目曾这样处理”,不该把一条旧记录包装成永远正确的公司规定。
三个很容易踩的坑
第一个坑,是追求录得多。
63 万份纪要是一个有分量的应用规模,但对多数企业来说,第一阶段更该看多少关键决定完成了确认、多少次重复追问被减少。录音数量很容易统计,知识有没有被再次使用才更接近结果。
第二个坑,是让 AI 自动发布结论。
会议上有分歧很正常。AI 为了生成一段顺畅摘要,可能会抹平分歧,把“倾向于”写成“决定”。涉及质量、安全、合同和客户承诺时,人工确认不能省。
第三个坑,是把所有知识开放给所有人。
知识可检索,不等于权限可以消失。客户数据、员工信息、产品规划和安全事件仍要沿用原系统的访问边界。搜索结果也应继承用户权限,而不是因为接入 AI 就多看一层。
企业知识库的价值,不是让员工少问一句话
一个新人搜到“这个缺陷当时没有拦截”,只能节省一次询问。
如果他还能看到当时依据的版本、风险评估、反对意见、适用范围和确认人,他才有机会判断今天能不能照做。这样的知识还能继续进入测试用例补齐、自动化回归、风险清单和新员工培训,减少同一类判断反复从零开始。
制度告诉员工通常该怎么做,暗知识解释组织在复杂情况下为什么这样做。前者让工作有秩序,后者让经验能够接班。
公司最贵的知识,往往没有写在最厚的手册里。它可能只是评审会上那句:“这个版本不能照旧处理,因为去年那次事故就是从这里开始的。”
把这句话留下来并不难。难的是保留它的出处、条件、责任和有效期,让下一位员工找到它时,知道该相信到什么程度。
这才是企业知识库该做的事。
你们公司有哪些重要判断,现在仍然只能靠“问某个人”才能得到?
资料来源:飞书案例:小鹏汽车用 AI 会议纪要沉淀组织信息、飞书 2025 年总结:小鹏上半年生成超 63 万份 AI 会议纪要。
完