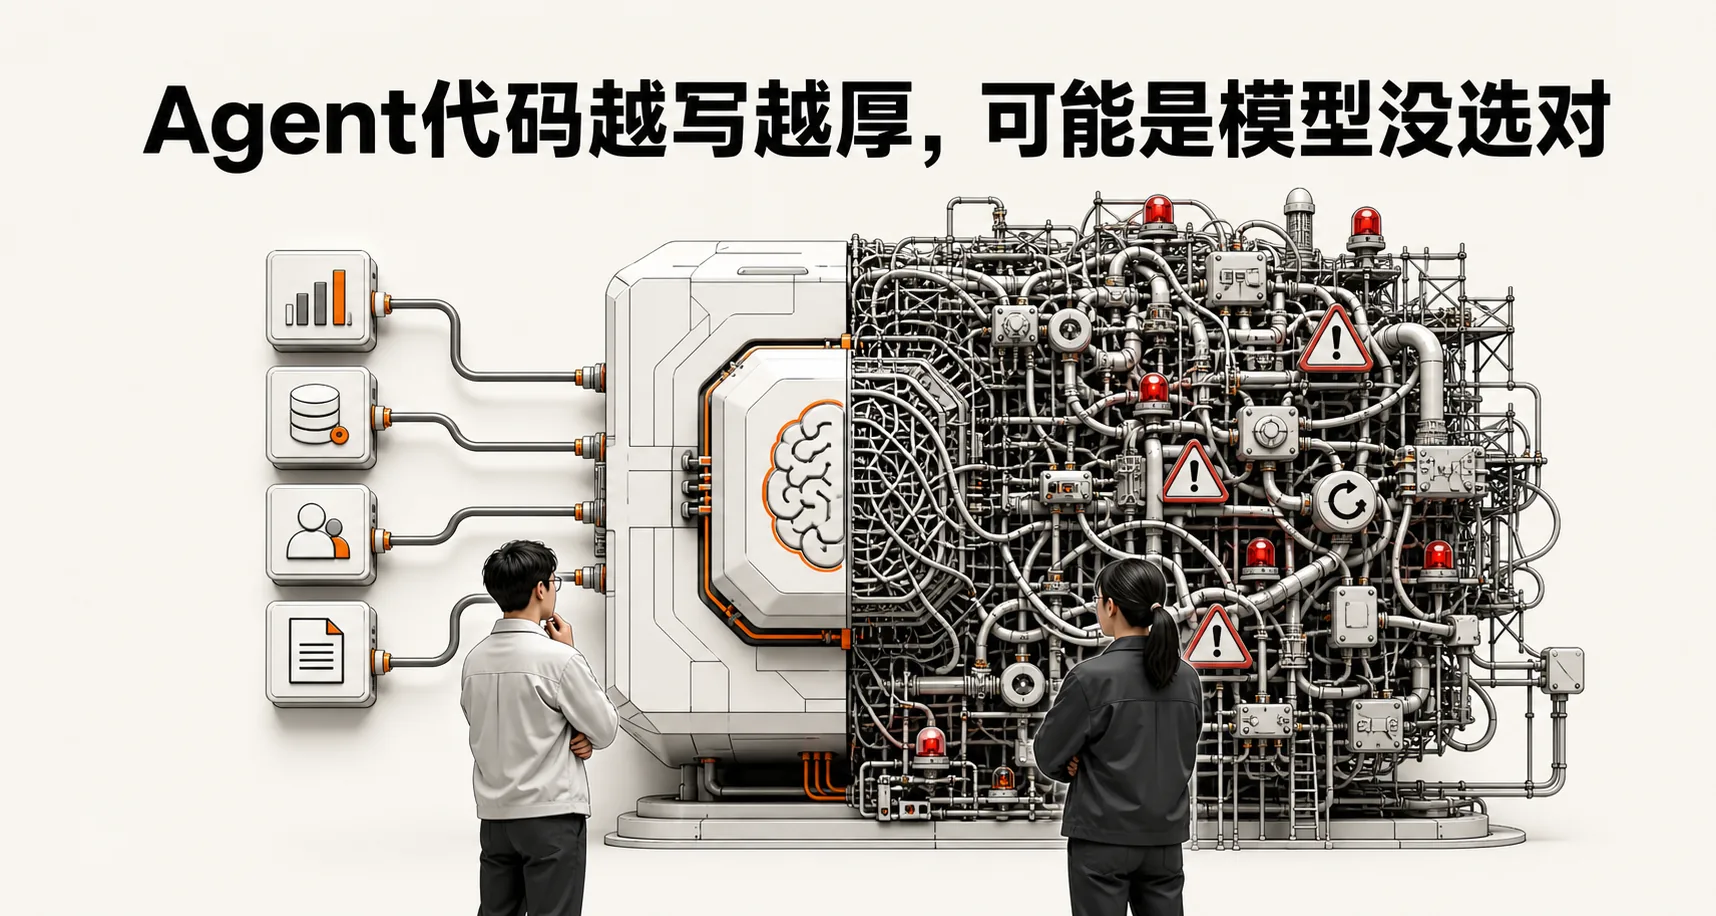
去年有一段时间,我同时维护两个 Agent 项目。技术栈接近,业务复杂度也差不多。
一开始,我们把这理解为工程成熟度不同。
后来把两条执行轨迹摊开,才发现真正的差距来自更底层的地方:一个模型能把工具、状态和任务目标稳稳接住;另一个模型,需要工程团队不断替它纠错。
看一个基座模型适不适合做 Agent,不要只看榜单,也要看你需要在它外面包多厚的保护壳。
但先说清楚:代码行数不是模型能力的单一评分。
真正值得看的,是项目中有多少代码在创造业务能力,又有多少代码只是在补偿模型的不稳定。
同样一个任务,为什么一个三步完成,一个跑了十七步?
设想一个请求:"帮我订一张下周三去杭州的机票,尽量靠窗,然后把行程发到企业微信。"
它包含时间解析、航班搜索、偏好筛选和消息发送,跨越多个系统。任何一次工具选错、参数填错、状态遗失或提前结束,都可能让整条链路失败。
参考案例中,同一个订单查询任务,一个模型用 3 步完成;换一个模型后用了 17 步,中间多次选错工具、生成不存在的参数,单次 Token 消耗也从约 1200 上升到约 14000。
这些数字是案例观察,不是通用基准。但它揭示的工程问题非常真实:
Agent成本不是单次模型调用价格,而是完成一次正确任务需要付出的全部代价。
真正拉开差距的,是三种稳定性
1. 工具调用稳定性
不是"会不会调用",而是能否在正确时机选择正确工具,生成合法参数,并在工具失败后正确恢复。
2. 结构化输出稳定性
要求 JSON,就不能偶尔包代码块;字段必填就不能漏;Schema 不存在的字段也不能自行创造。
结构化输出失败后,往往跟着解析、修复、重试、重复 Token 和状态污染。比"能不能生成 JSON"更有意义的,是Schema 一次通过率。
3. 长链路完成稳定性
五步任务不能走到第三步就提前收工;要求查询四个数据源,不能只查两个就开始汇总。
真正关心的不是模型能否答对一道孤立题,而是能否在真实业务链里持续、可预期地把活干完。
别只数总代码,要数"补偿性代码"
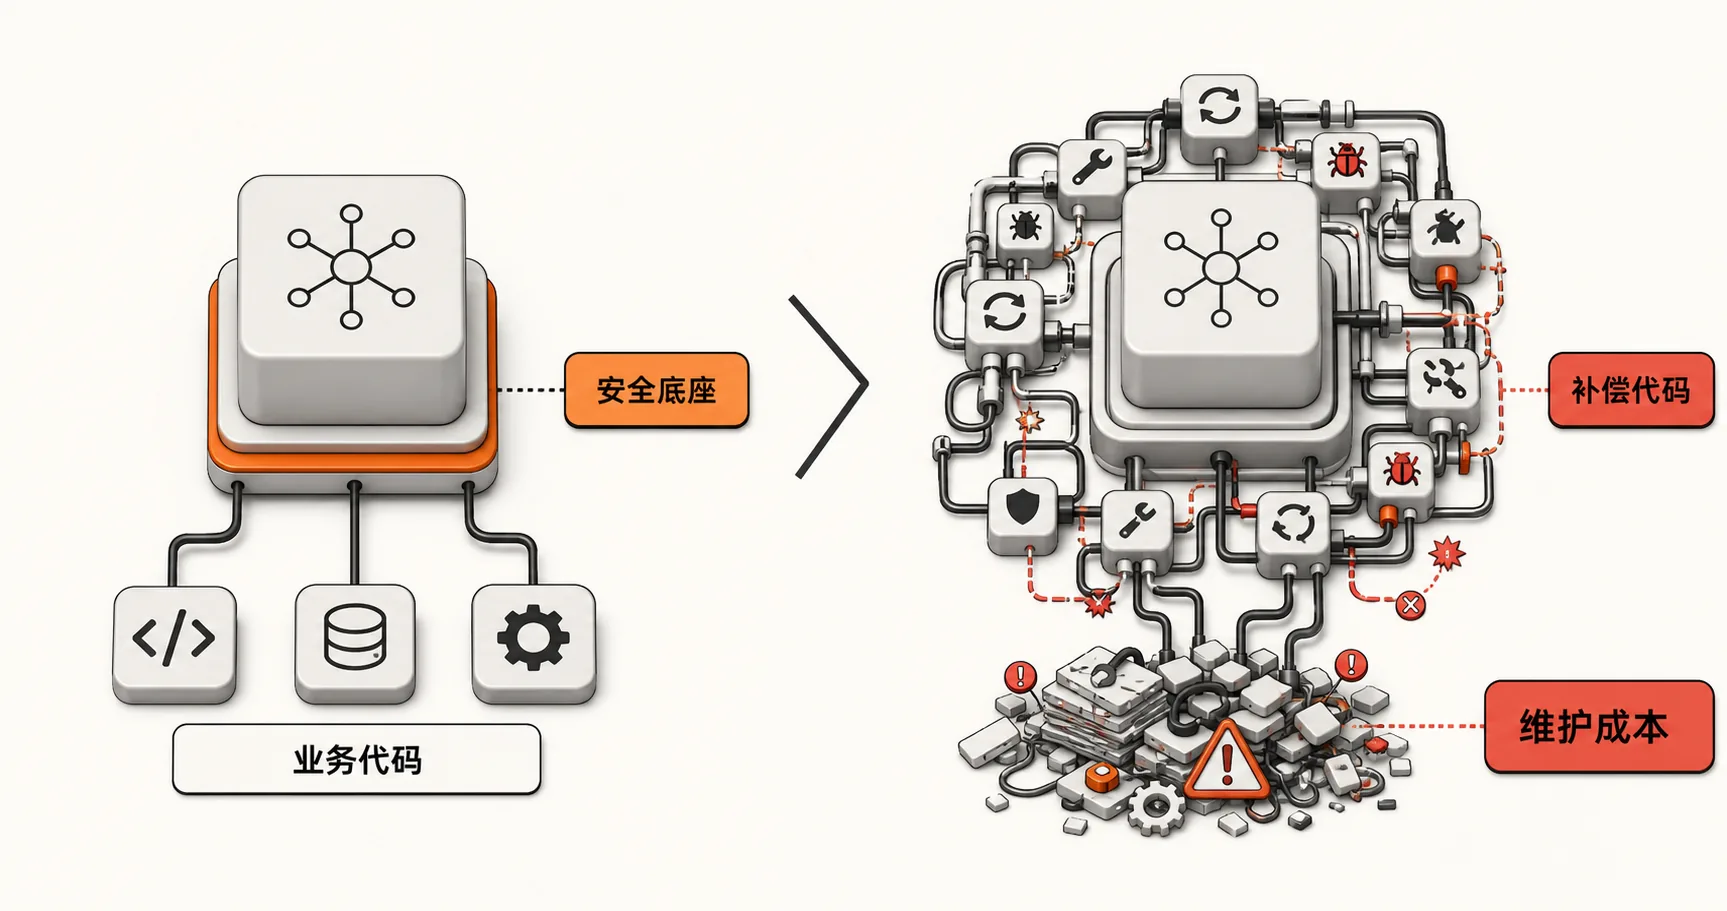
严肃的 Agent 系统无论模型多强,都需要权限、审计、幂等、超时、人工确认和确定性规则。不能把这些必要工程也当成模型缺陷。
更有用的做法,是把代码分成三类:
业务代码
连接真实系统,表达业务规则,完成审批、查询、写入和交付。
安全与治理代码
负责权限、审计、幂等、数据边界、人工确认和风险拦截。
模型补偿代码
反复修 JSON、猜工具参数、遮罩易错工具、为提前结束补状态机、为幻觉增加多层校验和恢复。
一个好模型,省下的不只是代码
保护壳变厚,会带来更多测试分支、恢复状态、异常会话、历史补丁和升级回归。
因此模型稳定性会形成乘法效应:提高一点,可能同时减少重试、Token、延迟、告警和人工接管;弱一点,增加的则是整条交付链的复杂度。
一个单价高、三步完成的模型,可能比一个单价低、十七步完成的模型便宜得多。
模型选型,不要拿榜单代替自己的评测集
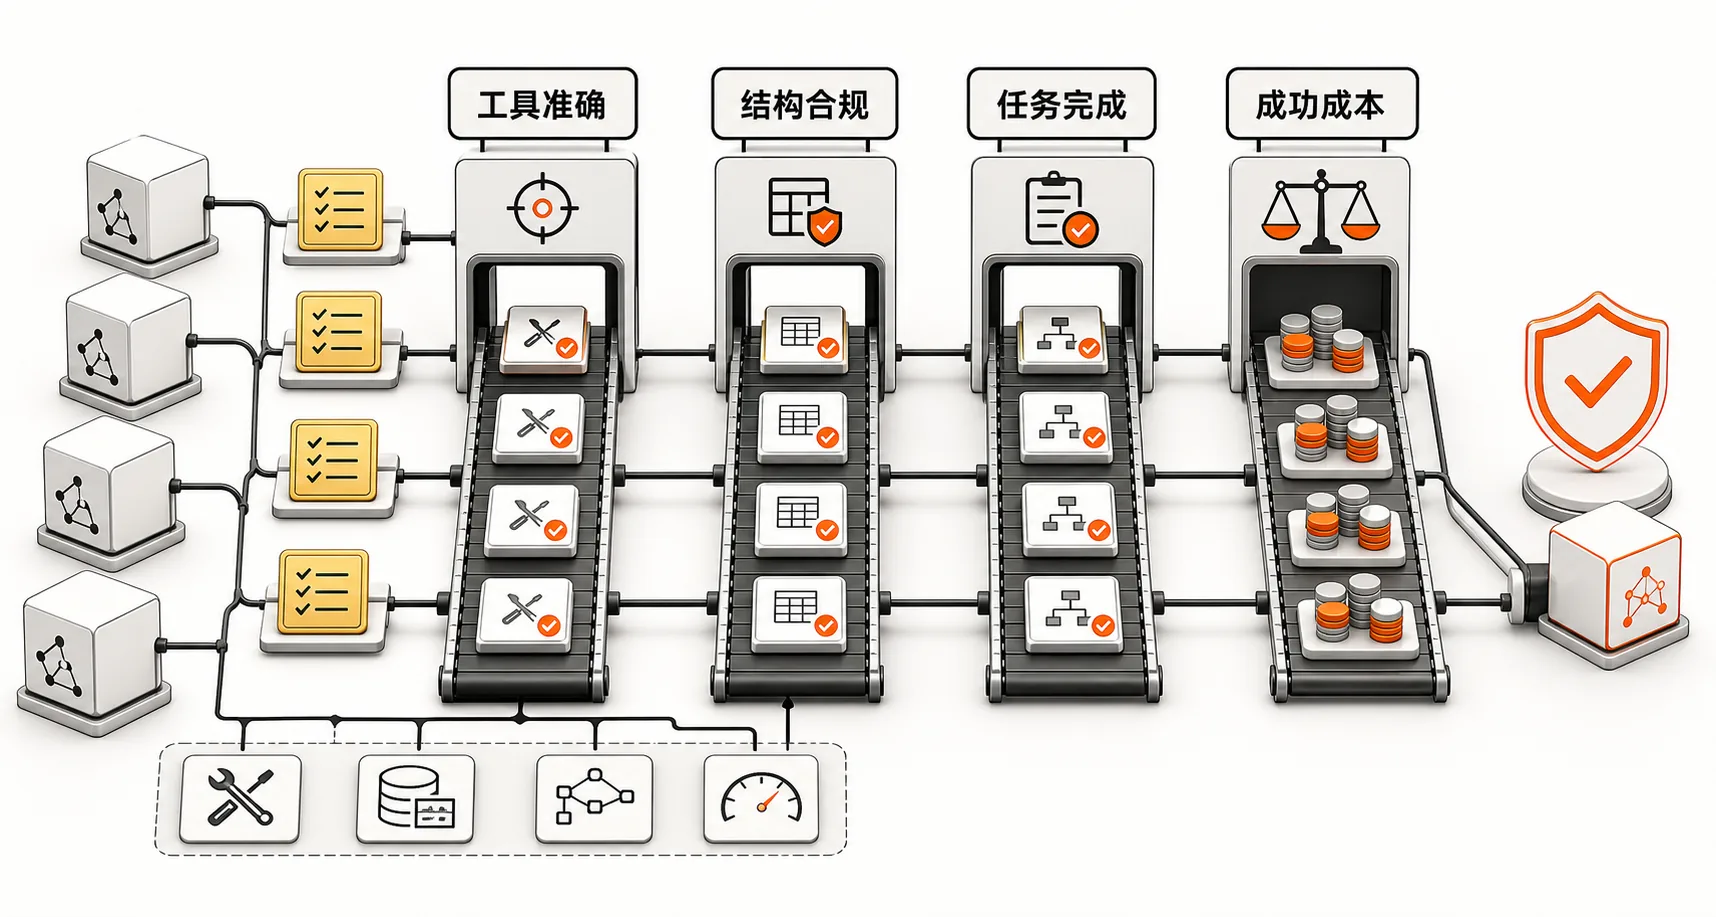
- 从真实流程整理 50—200 个黄金任务;
- 给候选模型相同的工具、Schema、提示和预算;
- 保存工具选择、参数、输出、错误和重试轨迹;
- 统计成功率、延迟、Token、接管和补偿逻辑;
- 按单位成功任务成本排序;
- 上线前补充故障、越权、无答案和中断恢复测试。
这个判断,对招聘和面试同样有用
"搭建 Agent、注册多个工具、使用某某框架",已经很难证明一个人真正做过生产项目。
不要只写:基于某框架搭建多工具 Agent,实现订单查询与自动处理。
可以写成:针对订单 Agent 建立 120 条黄金任务评测集,记录工具选择、Schema 合规与完整完成率;通过工具裁剪、轨迹分析和失败恢复,将成功率从 X 提升至 Y,平均步骤从 A 降至 B,人工接管率下降 C。
数字必须来自真实记录。面试官更想听的是:模型在哪里跑飞,你如何从 Trace 找到原因,哪些问题换模型,哪些问题必须确定性兜底,改完后成功率、成本和延迟发生了什么。
最后:最强的工程,不是把所有问题都写成代码
Agent 工程师真正的判断力,是知道每一种复杂度应该由谁承担。
稳定的权限与审计交给工程系统;确定的业务规则交给代码;模糊意图、规划与语义判断交给模型。
如果模型长期做不好它应该承担的部分,不要无限增加补丁。重新评测模型、收窄任务边界,或者把关键步骤改回确定性流程,往往更诚实。
好模型的价值,不只是回答更聪明,而是让整个系统更简单。
下一次接手 Agent 项目,先问:保护壳里哪类代码增长最快?如果明天换一个更稳定的模型,哪些代码可以安全删除?